Modèles génératifs : diffusion et flow matching
Préparation · niveau M1 → M2 · ≈ 30 h
Objectifs
Ce module est le cœur méthodologique du parcours : il construit, démonstrations à l’appui, les deux familles de modèles génératifs que le stage MilaDy doit comparer, la diffusion et le flow matching. À la fin des trente heures prévues, vous saurez :
- expliquer ce qu’est un modèle génératif comme le transport d’une loi simple vers la loi des données, écrire la formule du changement de variables et calculer la log-vraisemblance d’un flot normalisant ;
- dériver la loi marginale du processus de bruitage de DDPM, la loi a posteriori d’un pas, la borne variationnelle et la perte de prédiction du bruit, puis programmer l’échantillonnage ancestral ;
- passer à la limite continue (équations différentielles stochastiques directe et inverse, équation différentielle ordinaire de flot de probabilité), démontrer l’équivalence de Vincent entre score matching explicite et par débruitage, ainsi que la formule de Tweedie ;
- démontrer que le champ de vitesse marginal engendre le chemin de probabilité (équation de continuité) et que la perte conditionnelle de flow matching a le même gradient que la perte marginale ; relier flow matching, rectified flow, interpolants stochastiques et diffusion ;
- conditionner un modèle par un paramètre physique \boldsymbol\lambda (par exemple Re ou Rm), programmer le guidage sans classifieur, expliquer le guidage par l’estimation débruitée (DPS, universal guidance) et calculer l’écart de Jensen qu’il introduit ;
- décrire la génération dans un espace latent et dans un espace de fonctions (diffusion latente, FunDiff, Functional Flow Matching) et dire où y placer une contrainte comme \nabla\cdot\mathbf{B} = 0 ;
- évaluer un modèle génératif sans vraisemblance, par des distances entre échantillons (distance d’énergie, Wasserstein tranché) et par des métriques physiques, en comparant toujours au plancher de bruit.
Prérequis
Le niveau visé à l’entrée est celui d’un étudiant de première année de master (M1) qui a suivi les modules précédents du parcours. Il faut être à l’aise avec les lois gaussiennes multivariées (moyenne, covariance, conditionnement d’un vecteur gaussien), l’espérance conditionnelle et sa propriété de projection orthogonale dans L^2, la divergence de Kullback–Leibler, et les bases du calcul stochastique (mouvement brownien, équation de Fokker–Planck). Ces notions sont traitées dans le module Probabilités, statistiques et transport optimal ; l’équation de Fokker–Planck et le générateur d’une dynamique bruitée apparaissent aussi dans Systèmes dynamiques, bifurcations et mesures invariantes.
Côté apprentissage, il faut savoir écrire en PyTorch une boucle d’entraînement (perceptron multicouche, optimiseur Adam, rétropropagation), ce que couvre le module Apprentissage profond pour la physique. La divergence d’un champ et la projection de Leray, utilisées au chapitre 6, viennent du module Calcul vectoriel et analyse de Fourier.
Ce module prépare directement le dernier du parcours, Modèles génératifs sous contraintes physiques, qui reprend les outils construits ici pour imposer divergence nulle, bilans d’énergie et conditions aux limites.
Conventions de ce module Le site suit la convention du flow matching (voir les notations communes) : le bruit est \mathbf{x}_0 \sim \mathcal{N}(0, I), les données sont \mathbf{x}_1 \sim \mu et le temps du flot t va de 0 (bruit) à 1 (données). La littérature de la diffusion utilise la convention inverse, où \mathbf{x}_0 désigne la donnée. Pour éviter toute confusion, les chapitres 2 et 3 notent \mathbf{y}_k (temps discret) ou \mathbf{y}_s (temps continu s \in [0, 1]) l’état bruité de la diffusion, avec \mathbf{y}_0 = donnée ; on passe d’une convention à l’autre par t = 1 - s. Les normes sont euclidiennes, \|\cdot\|, et toutes les pertes sont écrites sans facteur \tfrac12.
Plan de travail
Le niveau indique la difficulté : 1 pour les fondations, 2 pour le cœur du module, 3 pour ce qui touche déjà aux questions de recherche du stage. Il ne redescend jamais d’une séance à la suivante.
| Séance | Durée | Niveau | Contenu | Exercices |
|---|---|---|---|---|
| 1 | 3 h | 1 | Chapitre 1 : transport d’une loi, vraisemblance et ses limites, flots normalisants, flots continus | 1, 2 |
| 2 | 4 h | 2 | Chapitre 2 : processus direct, loi a posteriori, borne variationnelle, prédiction du bruit, échantillonnage DDPM | 3, 4 |
| 3 | 5 h | 2 | Chapitre 3 : EDS directe et inverse, ODE de flot de probabilité, score matching (Vincent, Tweedie), EDM | 5, 6, 7 |
| 4 | 4 h | 2 | Chapitre 4, sections 4.1 à 4.3 : équation de continuité, champ marginal, théorème des gradients, exemple gaussien | 8, 9 |
| 5 | 3 h | 3 | Chapitre 4, sections 4.4 à 4.6 : rectified flow, interpolants stochastiques, lien vitesse–score | 10, 11 |
| 6 | 5 h | 3 | Chapitre 5 : conditionnement par \boldsymbol\lambda, guidage sans classifieur, DPS, écart de Jensen, travail pratique | 12, 13, 14 |
| 7 | 3 h | 3 | Chapitre 6 : diffusion latente, bruit en espace de fonctions, FunDiff, Functional Flow Matching | 15 |
| 8 | 3 h | 3 | Chapitre 7 : évaluation, distance d’énergie, Wasserstein tranché, métriques physiques, comparaison avec DDPM | 16 |
| Total | 30 h | 7 chapitres | 16 exercices |
Chaque séance se termine par les exercices indiqués, à chercher avant de lire leur solution. Les blocs de code sont autonomes : chacun tourne tel quel, en moins de trente secondes sur un processeur, avec NumPy, SciPy et PyTorch. Les sorties recopiées en commentaire ont été obtenues en exécutant les blocs sur un seul cœur de calcul ; vos chiffres peuvent différer légèrement selon la version des bibliothèques.
1. Qu’est-ce qu’un modèle génératif ?
Le stage MilaDy cherche à produire, pour un jeu de paramètres \boldsymbol\lambda = (Re, Rm, \dots), des champs magnétohydrodynamiques (MHD) qui ont la même loi statistique que ceux d’une simulation, sans relancer la simulation. On dispose d’échantillons (des instantanés), pas d’une formule pour leur densité. Ce chapitre pose le cadre : un modèle génératif est une machine à fabriquer des échantillons d’une loi apprise, et la façon la plus naturelle de la construire est de transporter une loi simple, le bruit gaussien, vers la loi des données.
1.1 Transporter une loi simple vers la loi des données
Définition 1.1 — Loi image (poussée en avant) Soit \rho une loi de probabilité sur \mathbb{R}^d et T : \mathbb{R}^d \to \mathbb{R}^D une application mesurable. La loi image de \rho par T, notée T_\#\rho, est définie par T_\#\rho(A) = \rho\big(T^{-1}(A)\big) pour tout ensemble mesurable A. De façon équivalente, si \mathbf{z} \sim \rho alors T(\mathbf{z}) \sim T_\#\rho, et pour toute fonction test \varphi bornée :
\mathbb{E}_{T_\#\rho}[\varphi] = \mathbb{E}_{\mathbf{z} \sim \rho}\big[\varphi(T(\mathbf{z}))\big].
Définition 1.2 — Modèle génératif Un modèle génératif est une famille de lois q_\theta sur \mathbb{R}^D, indexée par des paramètres \theta (les poids d’un réseau), dont on sait tirer des échantillons à faible coût, et que l’on ajuste pour que q_\theta soit proche de la loi des données \mu. Le modèle est conditionnel s’il dépend d’une variable \boldsymbol\lambda, q_\theta(\cdot \mid \boldsymbol\lambda) \approx \mu_{\boldsymbol\lambda}. Il est explicite si l’on sait aussi évaluer sa densité, implicite sinon. Un modèle par transport s’écrit q_\theta = (T_\theta)_\#\rho_0 avec \rho_0 = \mathcal{N}(0, I).
La question n’est jamais de savoir si un transport existe : en dimension 1, il est donné explicitement par la fonction de répartition, et en dimension quelconque le théorème de Brenier (module p5) garantit l’existence d’un transport optimal dès que la source a une densité. La difficulté est d’apprendre ce transport à partir d’échantillons seulement, en grande dimension.
Proposition 1.3 — Transport en dimension 1 Soit \mu une loi sur \mathbb{R} de fonction de répartition F, d’inverse généralisée F^{-1}(u) = \inf\{x : F(x) \ge u\}, et \Phi la fonction de répartition de \mathcal{N}(0, 1). Alors T = F^{-1} \circ \Phi transporte \mathcal{N}(0, 1) sur \mu : si Z \sim \mathcal{N}(0, 1), alors T(Z) \sim \mu.
Preuve. La variable U = \Phi(Z) suit la loi uniforme sur ]0, 1[, car \mathbb{P}(\Phi(Z) \le u) = \mathbb{P}(Z \le \Phi^{-1}(u)) = u. Comme F est croissante et continue à droite, on a l’équivalence F^{-1}(u) \le x \iff u \le F(x). Donc \mathbb{P}(F^{-1}(U) \le x) = \mathbb{P}(U \le F(x)) = F(x) : la variable F^{-1}(U) a pour fonction de répartition F. ∎
Exemple 1.4 — Loi exponentielle Pour la loi exponentielle de paramètre 1, F(x) = 1 - e^{-x} pour x \ge 0, donc T(z) = -\ln\big(1 - \Phi(z)\big). Le point z = 0, médiane de la gaussienne, est envoyé sur T(0) = \ln 2 \approx 0{,}693, médiane de la loi exponentielle. L’application T est croissante : elle « étire » la queue droite de la gaussienne et « comprime » sa queue gauche contre 0.
1.2 La vraisemblance et ses limites
Quand le modèle est explicite, le critère le plus classique pour l’ajuster est la vraisemblance des données.
Définition 1.5 — Maximum de vraisemblance Étant donnés des échantillons \mathbf{x}^{(1)}, \dots, \mathbf{x}^{(N)} de \mu et un modèle de densité q_\theta, la log-vraisemblance moyenne est \ell(\theta) = \frac1N \sum_{i=1}^N \log q_\theta(\mathbf{x}^{(i)}). L’estimateur du maximum de vraisemblance maximise \ell.
Proposition 1.6 — Vraisemblance et divergence de Kullback–Leibler Si \mu a une densité (notée encore \mu) d’entropie H(\mu) = -\mathbb{E}_\mu[\log \mu] finie, alors
\mathbb{E}_{\mathbf{x} \sim \mu}\big[\log q_\theta(\mathbf{x})\big] = -H(\mu) - \mathrm{KL}(\mu \,\|\, q_\theta).
Maximiser la log-vraisemblance moyenne revient donc, quand N \to \infty, à minimiser \mathrm{KL}(\mu \,\|\, q_\theta) \ge 0.
Preuve. Par définition, \mathrm{KL}(\mu \,\|\, q_\theta) = \mathbb{E}_\mu[\log \mu - \log q_\theta] = -H(\mu) - \mathbb{E}_\mu[\log q_\theta], ce qui donne l’identité. Le terme H(\mu) ne dépend pas de \theta. La positivité de la divergence résulte de l’inégalité de Jensen appliquée à la fonction concave \log : -\mathrm{KL} = \mathbb{E}_\mu[\log(q_\theta/\mu)] \le \log \mathbb{E}_\mu[q_\theta/\mu] = \log 1 = 0. Enfin, la loi des grands nombres donne \ell(\theta) \to \mathbb{E}_\mu[\log q_\theta]. ∎
La vraisemblance a pourtant quatre limites, qui expliquent pourquoi les modèles de ce module ne s’entraînent pas, en pratique, en la maximisant directement.
Remarque 1.7 — Quatre limites de la vraisemblance (a) Elle exige une densité calculable. Pour un modèle par transport, cela impose que T_\theta soit inversible et que l’on sache calculer le déterminant de sa jacobienne, ce qui coûte en général O(D^3) opérations.
Elle pèse les erreurs de façon asymétrique. La divergence \mathrm{KL}(\mu \,\|\, q) pénalise lourdement un modèle qui met une densité presque nulle là où il y a des données, mais presque pas un modèle qui met de la masse là où il n’y en a pas : le maximum de vraisemblance « couvre » tous les modes, quitte à remplir l’espace entre eux.
En grande dimension, elle dit peu de chose de la qualité des échantillons. Si q = 0{,}01\,p + 0{,}99\,r mélange un excellent modèle p avec un modèle r qui ne produit que du bruit, alors \log q \ge \log p - \ln 100 en tout point : la log-vraisemblance perd au plus 4{,}6 nats, une quantité négligeable devant une log-vraisemblance proportionnelle à la dimension D \sim 10^6, alors que 99 % des échantillons sont inutilisables. Theis et al. (2016) montrent plus généralement que vraisemblance et qualité des échantillons sont largement indépendantes en grande dimension.
Elle ignore la physique. Une bonne vraisemblance ne garantit ni \nabla\cdot\mathbf{B} = 0, ni le bon spectre d’énergie, ni le bon bilan d’énergie. Le chapitre 7 revient sur l’évaluation.
1.3 Flots normalisants : le changement de variables
Les flots normalisants (Rezende & Mohamed, 2015 ; revue de Papamakarios et al., 2021) sont des modèles par transport explicites : on choisit T_\theta inversible, de jacobienne facile à calculer, et la densité découle du changement de variables.
Théorème 1.8 — Changement de variables Soit T : \mathbb{R}^D \to \mathbb{R}^D un C^1-difféomorphisme et \mathbf{z} de densité \rho_0. Alors \mathbf{x} = T(\mathbf{z}) a pour densité
q(\mathbf{x}) = \rho_0\big(T^{-1}(\mathbf{x})\big)\,\big|\det J_{T^{-1}}(\mathbf{x})\big|,
soit, en notant \mathbf{z} = T^{-1}(\mathbf{x}) le point source,
\log q(\mathbf{x}) = \log\rho_0(\mathbf{z}) - \log\big|\det J_T(\mathbf{z})\big|.
Pour une composition T = T_L \circ \dots \circ T_1, avec \mathbf{z}_0 = \mathbf{z} et \mathbf{z}_l = T_l(\mathbf{z}_{l-1}), les log-déterminants s’additionnent : \log q(\mathbf{x}) = \log\rho_0(\mathbf{z}) - \sum_{l=1}^L \log|\det J_{T_l}(\mathbf{z}_{l-1})|.
Preuve. Pour toute fonction \varphi bornée, \mathbb{E}[\varphi(T(\mathbf{z}))] = \int \varphi(T(\mathbf{z}))\,\rho_0(\mathbf{z})\,\mathrm{d}\mathbf{z}. Le changement de variables \mathbf{x} = T(\mathbf{z}), licite pour un difféomorphisme, donne \mathrm{d}\mathbf{z} = |\det J_{T^{-1}}(\mathbf{x})|\,\mathrm{d}\mathbf{x}, d’où \mathbb{E}[\varphi(\mathbf{x})] = \int \varphi(\mathbf{x})\,\rho_0(T^{-1}(\mathbf{x}))\,|\det J_{T^{-1}}(\mathbf{x})|\,\mathrm{d}\mathbf{x}. Cette identité, vraie pour toute \varphi, identifie la densité de \mathbf{x}. La seconde forme vient de J_{T^{-1}}(\mathbf{x}) = J_T(\mathbf{z})^{-1}, et la formule pour une composition de la multiplicativité du déterminant (règle de dérivation des fonctions composées). ∎
Exemple 1.9 — Flot affine Pour T(\mathbf{z}) = A\mathbf{z} + \mathbf{b} avec A inversible, la loi image de \mathcal{N}(0, I) est \mathcal{N}(\mathbf{b}, AA^\top) et
\log q(\mathbf{x}) = -\tfrac{D}{2}\log(2\pi) - \tfrac12\big\|A^{-1}(\mathbf{x} - \mathbf{b})\big\|^2 - \log|\det A|.
Le maximum de vraisemblance donne alors \mathbf{b} = moyenne empirique et AA^\top = covariance empirique (exercice 2) : un flot affine ne sait représenter que des lois gaussiennes. Il faut des transformations non linéaires dont on contrôle le déterminant.
Définition 1.10 — Couche de couplage affine (Real NVP) On coupe \mathbf{z} = (\mathbf{z}_a, \mathbf{z}_b) en deux blocs. La couche de couplage affine de Dinh et al. (2017) est
T(\mathbf{z})_a = \mathbf{z}_a, \qquad T(\mathbf{z})_b = \mathbf{z}_b \odot \exp\big(\mathbf{s}(\mathbf{z}_a)\big) + \mathbf{m}(\mathbf{z}_a),
où \mathbf{s} et \mathbf{m} sont deux réseaux quelconques et \odot le produit composante par composante.
Proposition 1.11 — Inverse et déterminant d’une couche de couplage La couche de couplage est inversible, d’inverse \mathbf{z}_a = \mathbf{x}_a, \mathbf{z}_b = (\mathbf{x}_b - \mathbf{m}(\mathbf{x}_a)) \odot \exp(-\mathbf{s}(\mathbf{x}_a)), et \log|\det J_T(\mathbf{z})| = \sum_i s_i(\mathbf{z}_a).
Preuve. L’inverse se lit directement, car \mathbf{x}_a = \mathbf{z}_a est connu. La jacobienne est triangulaire par blocs : le bloc \partial T_a/\partial \mathbf{z}_a vaut I, le bloc \partial T_a/\partial \mathbf{z}_b est nul, et le bloc \partial T_b/\partial \mathbf{z}_b est la matrice diagonale \mathrm{diag}(\exp \mathbf{s}(\mathbf{z}_a)). Le déterminant d’une matrice triangulaire par blocs est le produit des déterminants des blocs diagonaux, soit \prod_i e^{s_i}. Le bloc \partial T_b/\partial \mathbf{z}_a, qui contient les dérivées des réseaux, n’intervient pas. ∎
En alternant les blocs d’une couche à l’autre, on obtient un transport très non linéaire dont la vraisemblance se calcule exactement, en O(D) opérations par couche. Le prix à payer est une architecture contrainte : chaque couche doit rester inversible et « triangulaire ».
1.4 Flots continus et formule de Liouville
Une autre façon de garantir l’inversibilité est de définir T comme le flot d’une équation différentielle ordinaire (EDO) : c’est l’idée des flots continus (Chen et al., 2018), qui mène directement au flow matching du chapitre 4.
Proposition 1.12 — Variation de la log-densité le long d’un flot Soit v(\mathbf{x}, t) un champ de vitesse régulier, \mathbf{x}_t une solution de \dot{\mathbf{x}}_t = v(\mathbf{x}_t, t) avec \mathbf{x}_0 \sim p_0, et p_t la densité de \mathbf{x}_t. Alors
\frac{\mathrm{d}}{\mathrm{d}t}\log p_t(\mathbf{x}_t) = -(\nabla\cdot v)(\mathbf{x}_t, t),
et donc, en intégrant le long de la trajectoire,
\log p_1(\mathbf{x}_1) = \log p_0(\mathbf{x}_0) - \int_0^1 (\nabla\cdot v)(\mathbf{x}_t, t)\,\mathrm{d}t.
Preuve. Esquisse. La densité transportée vérifie l’équation de continuité \partial_t p_t + \nabla\cdot(p_t v) = 0 (théorème 4.2). Le long d’une trajectoire, la règle de dérivation donne \frac{\mathrm{d}}{\mathrm{d}t}p_t(\mathbf{x}_t) = \partial_t p_t + v\cdot\nabla p_t = -\nabla\cdot(p_t v) + v\cdot\nabla p_t = -p_t\,\nabla\cdot v. On divise par p_t > 0 et on intègre de 0 à 1. ∎
Cette formule rend la vraisemblance calculable pour n’importe quel champ v, sans contrainte d’architecture. Mais entraîner par maximum de vraisemblance exige, à chaque pas d’optimisation, d’intégrer l’EDO et la divergence de v (une trace de jacobienne) puis de rétropropager à travers le solveur : c’est très coûteux. Toute l’astuce de la diffusion et du flow matching est d’apprendre un tel transport sans simuler l’EDO pendant l’entraînement, par une simple régression.
Exemple 1.13 — Vérification numérique du changement de variables Le bloc suivant pousse \mathcal{N}(0, 1) par T(z) = z + 4\tanh z, application strictement croissante. La densité image, calculée par le théorème 1.8, a deux bosses ; on la compare à un histogramme de 10^6 échantillons, puis on vérifie que la log-vraisemblance moyenne calculée côté données coïncide avec \mathbb{E}[\log\rho_0(Z) - \log T'(Z)] calculée côté source.
import numpy as np
from scipy.stats import norm

# Transport T(z) = z + a tanh(z), strictement croissant dès que a > -1
a = 4.0
T = lambda z: z + a * np.tanh(z)
dT = lambda z: 1 + a / np.cosh(z) ** 2

def T_inv(x, iters=60):            # inversion par la méthode de Newton
    z = np.array(x, dtype=float)
    for _ in range(iters):
        z -= (T(z) - x) / dT(z)
    return z

def q(x):                          # densité poussée : q(x) = ρ0(T⁻¹(x)) / T'(T⁻¹(x))
    z = T_inv(x)
    return norm.pdf(z) / dT(z)

rng = np.random.default_rng(0)
x = T(rng.standard_normal(1_000_000))          # 10⁶ échantillons de q = T#ρ0
hist, bords = np.histogram(x, bins=120, range=(-9, 9), density=True)
centres = 0.5 * (bords[1:] + bords[:-1])
print("écart max histogramme / formule :", round(np.abs(hist - q(centres)).max(), 4))
grille = np.linspace(-15, 15, 30001)
print("intégrale de q                  :", round(np.trapezoid(q(grille), grille), 6))
print("q(0) =", round(q(0.0), 4), " ; q(3.92) =", round(q(3.92), 4), " : deux bosses")
print("log-vraisemblance moyenne        :", round(np.mean(np.log(q(x[:100_000]))), 4))
z = rng.standard_normal(1_000_000)               # même quantité calculée côté source :
print("E[log ρ0(Z) - log T'(Z)]         :", round(np.mean(norm.logpdf(z) - np.log(dT(z))), 4))
# sortie :
# écart max histogramme / formule : 0.002
# intégrale de q                  : 1.0
# q(0) = 0.0798  ; q(3.92) = 0.0904  : deux bosses
# log-vraisemblance moyenne        : -2.5657
# E[log ρ0(Z) - log T'(Z)]         : -2.5648
L’histogramme et la formule s’accordent à 2 \times 10^{-3} près, ce qui est l’ordre de grandeur de l’erreur statistique d’un histogramme à 120 classes. Les deux estimations de la log-vraisemblance diffèrent de 10^{-3}, là encore une fluctuation d’échantillonnage. Une application monotone et lisse suffit donc à transformer une gaussienne en une loi bimodale ; en grande dimension, tout le problème est de trouver une telle application à partir des seules données.
Ce qu’il faut retenir — chapitre 1
- Un modèle génératif par transport s’écrit q_\theta = (T_\theta)_\#\mathcal{N}(0, I) ; un transport existe toujours (fonction de répartition en dimension 1, théorème de Brenier en général), la difficulté est de l’apprendre.
- Maximiser la vraisemblance revient à minimiser \mathrm{KL}(\mu\,\|\,q_\theta) ; ce critère exige une densité calculable, couvre les modes et dit peu de la qualité des échantillons en grande dimension.
- Changement de variables : \log q(\mathbf{x}) = \log\rho_0(\mathbf{z}) - \log|\det J_T(\mathbf{z})| ; les couches de couplage rendent ce déterminant facile.
- Pour un flot continu, \frac{\mathrm{d}}{\mathrm{d}t}\log p_t(\mathbf{x}_t) = -\nabla\cdot v ; l’entraîner par vraisemblance demande de simuler l’EDO, ce que diffusion et flow matching évitent.
2. Modèles de diffusion : DDPM
Apprendre d’un seul coup un transport du bruit vers des champs turbulents est difficile. Les modèles de diffusion, introduits par Sohl-Dickstein et al. (2015) et rendus efficaces par Ho, Jain et Abbeel (2020) sous le nom de DDPM (Denoising Diffusion Probabilistic Models), découpent le problème : on détruit progressivement les données en ajoutant du bruit, opération triviale, puis on apprend à inverser chaque petit pas de bruitage, ce qui revient à apprendre un débruiteur. Ce chapitre suit la convention de la diffusion : \mathbf{y}_0 est une donnée, \mathbf{y}_K est presque du bruit pur.
2.1 Le processus direct
Définition 2.1 — Processus de bruitage gaussien Soient des nombres \beta_1, \dots, \beta_K \in\, ]0, 1[, en général croissants (le planning de bruit). Le processus direct est la chaîne de Markov
q(\mathbf{y}_k \mid \mathbf{y}_{k-1}) = \mathcal{N}\big(\sqrt{1 - \beta_k}\,\mathbf{y}_{k-1},\; \beta_k I\big), \qquad k = 1, \dots, K, \qquad \mathbf{y}_0 \sim \mu.
On note \alpha_k = 1 - \beta_k, \bar\alpha_k = \prod_{j=1}^k \alpha_j et \operatorname{RSB}_k = \bar\alpha_k/(1 - \bar\alpha_k) le rapport signal sur bruit.
Le facteur \sqrt{1 - \beta_k} n’est pas arbitraire : il contracte le signal juste assez pour que la variance totale reste bornée, de sorte que la chaîne converge vers \mathcal{N}(0, I) au lieu d’exploser.
Proposition 2.2 — Loi marginale du processus direct Pour tout k, q(\mathbf{y}_k \mid \mathbf{y}_0) = \mathcal{N}\big(\sqrt{\bar\alpha_k}\,\mathbf{y}_0,\; (1 - \bar\alpha_k) I\big). Autrement dit, on peut tirer \mathbf{y}_k directement, sans simuler la chaîne :
\mathbf{y}_k = \sqrt{\bar\alpha_k}\,\mathbf{y}_0 + \sqrt{1 - \bar\alpha_k}\,\boldsymbol\varepsilon, \qquad \boldsymbol\varepsilon \sim \mathcal{N}(0, I) \text{ indépendant de } \mathbf{y}_0.
Preuve. Par récurrence sur k. Le cas k = 1 est la définition, car \bar\alpha_1 = \alpha_1. Si la propriété est vraie au rang k - 1, on écrit \mathbf{y}_k = \sqrt{\alpha_k}\,\mathbf{y}_{k-1} + \sqrt{\beta_k}\,\boldsymbol\varepsilon_k = \sqrt{\alpha_k\bar\alpha_{k-1}}\,\mathbf{y}_0 + \sqrt{\alpha_k(1 - \bar\alpha_{k-1})}\,\boldsymbol\varepsilon' + \sqrt{\beta_k}\,\boldsymbol\varepsilon_k, avec \boldsymbol\varepsilon' et \boldsymbol\varepsilon_k gaussiens centrés réduits indépendants. Une somme de gaussiennes indépendantes est gaussienne, de variance \alpha_k(1 - \bar\alpha_{k-1}) + \beta_k = \alpha_k - \bar\alpha_k + 1 - \alpha_k = 1 - \bar\alpha_k. Comme \alpha_k\bar\alpha_{k-1} = \bar\alpha_k, on obtient le résultat au rang k. ∎
Si \bar\alpha_K \approx 0, la loi de \mathbf{y}_K est presque \mathcal{N}(0, I) quelle que soit la loi des données : c’est le point de départ de l’échantillonnage.
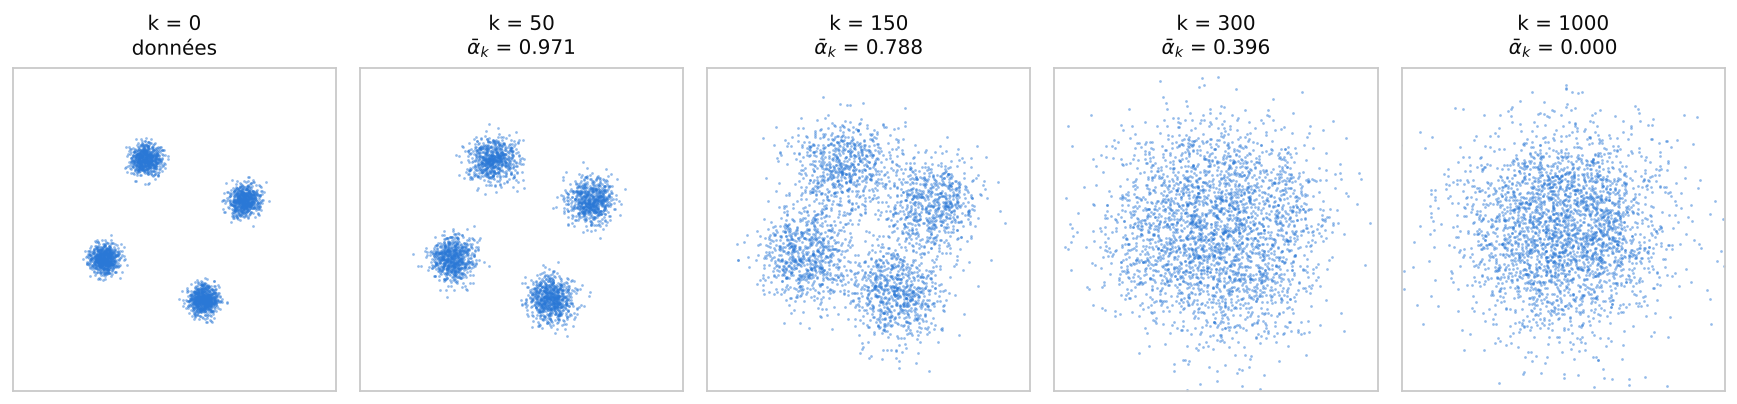
Exemple 2.3 — Planning linéaire de Ho et al. (2020) Avec K = 1000 et \beta_k croissant linéairement de 10^{-4} à 0{,}02, le bloc de code de la section 2.4 donne \bar\alpha_K = 4{,}0 \times 10^{-5} : la donnée ne pèse plus que \sqrt{\bar\alpha_K} \approx 0{,}006 dans \mathbf{y}_K. Le rapport signal sur bruit passe par 1 vers k = 250 (\operatorname{RSB}_{250} = 1{,}10) et vaut encore 8{,}7 à k = 100 : une grande partie des pas sert à détruire les petites échelles, une autre à effacer les grandes structures. La figure 2.4 montre l’effet du bruitage sur un mélange de quatre gaussiennes du plan.
2.2 La loi a posteriori d’un pas
Inverser le processus direct demande la loi de \mathbf{y}_{k-1} sachant \mathbf{y}_k. Elle est inaccessible en général, car elle dépend de la loi des données. En revanche, si l’on connaît aussi \mathbf{y}_0, elle est gaussienne et explicite.
Proposition 2.5 — Loi a posteriori sachant la donnée Pour k \ge 2, q(\mathbf{y}_{k-1} \mid \mathbf{y}_k, \mathbf{y}_0) = \mathcal{N}\big(\tilde{\boldsymbol\mu}_k(\mathbf{y}_k, \mathbf{y}_0),\; \tilde\beta_k I\big) avec
\tilde{\boldsymbol\mu}_k(\mathbf{y}_k, \mathbf{y}_0) = \frac{\sqrt{\bar\alpha_{k-1}}\,\beta_k}{1 - \bar\alpha_k}\,\mathbf{y}_0 + \frac{\sqrt{\alpha_k}\,(1 - \bar\alpha_{k-1})}{1 - \bar\alpha_k}\,\mathbf{y}_k
et une variance qui ne dépend que du planning :
\tilde\beta_k = \frac{1 - \bar\alpha_{k-1}}{1 - \bar\alpha_k}\,\beta_k.
Preuve. Par la formule de Bayes et la propriété de Markov, q(\mathbf{y}_{k-1} \mid \mathbf{y}_k, \mathbf{y}_0) \propto q(\mathbf{y}_k \mid \mathbf{y}_{k-1})\,q(\mathbf{y}_{k-1} \mid \mathbf{y}_0). Le logarithme du membre de droite vaut, à une constante près,
-\frac{\|\mathbf{y}_k - \sqrt{\alpha_k}\,\mathbf{y}_{k-1}\|^2}{2\beta_k} - \frac{\|\mathbf{y}_{k-1} - \sqrt{\bar\alpha_{k-1}}\,\mathbf{y}_0\|^2}{2(1 - \bar\alpha_{k-1})}.
C’est une forme quadratique en \mathbf{y}_{k-1} : la loi est gaussienne. Le coefficient de -\tfrac12\|\mathbf{y}_{k-1}\|^2, c’est-à-dire la précision, vaut \frac{\alpha_k}{\beta_k} + \frac{1}{1 - \bar\alpha_{k-1}} = \frac{\alpha_k(1 - \bar\alpha_{k-1}) + \beta_k}{\beta_k(1 - \bar\alpha_{k-1})} = \frac{1 - \bar\alpha_k}{\beta_k(1 - \bar\alpha_{k-1})} = \frac{1}{\tilde\beta_k}. Le coefficient du terme linéaire en \mathbf{y}_{k-1} est \frac{\sqrt{\alpha_k}}{\beta_k}\mathbf{y}_k + \frac{\sqrt{\bar\alpha_{k-1}}}{1 - \bar\alpha_{k-1}}\mathbf{y}_0 ; la moyenne est ce vecteur multiplié par la variance \tilde\beta_k, ce qui donne exactement \tilde{\boldsymbol\mu}_k. ∎
2.3 Le modèle inverse et la borne variationnelle
Définition 2.6 — Modèle inverse Le modèle génératif de DDPM est une chaîne de Markov qui remonte le temps : p(\mathbf{y}_K) = \mathcal{N}(0, I) et, pour k = K, \dots, 1,
p_\theta(\mathbf{y}_{k-1} \mid \mathbf{y}_k) = \mathcal{N}\big(\mathbf{m}_\theta(\mathbf{y}_k, k),\; \sigma_k^2 I\big),
où \mathbf{m}_\theta est un réseau et \sigma_k^2 une variance fixée (par exemple \beta_k ou \tilde\beta_k). La densité du modèle est p_\theta(\mathbf{y}_0) = \int p(\mathbf{y}_K)\prod_{k=1}^K p_\theta(\mathbf{y}_{k-1} \mid \mathbf{y}_k)\,\mathrm{d}\mathbf{y}_{1:K}.
Cette densité est une intégrale en dimension KD : on ne sait pas la calculer. On en maximise une borne inférieure.
Théorème 2.7 — Borne variationnelle Pour toute donnée \mathbf{y}_0,
-\log p_\theta(\mathbf{y}_0) \le L_K + \sum_{k=2}^K L_{k-1} + L_0,
avec L_K = \mathrm{KL}\big(q(\mathbf{y}_K \mid \mathbf{y}_0)\,\|\,p(\mathbf{y}_K)\big), qui ne dépend pas de \theta, L_0 = -\mathbb{E}_q\big[\log p_\theta(\mathbf{y}_0 \mid \mathbf{y}_1)\big] et, pour 2 \le k \le K,
L_{k-1} = \mathbb{E}_{q(\mathbf{y}_k \mid \mathbf{y}_0)}\Big[\mathrm{KL}\big(q(\mathbf{y}_{k-1} \mid \mathbf{y}_k, \mathbf{y}_0)\,\big\|\,p_\theta(\mathbf{y}_{k-1} \mid \mathbf{y}_k)\big)\Big].
Preuve. On introduit la loi du processus direct comme loi d’importance : \log p_\theta(\mathbf{y}_0) = \log \mathbb{E}_{q(\mathbf{y}_{1:K} \mid \mathbf{y}_0)}\big[p_\theta(\mathbf{y}_{0:K})/q(\mathbf{y}_{1:K} \mid \mathbf{y}_0)\big], et l’inégalité de Jensen (le logarithme est concave) permet de faire passer le logarithme dans l’espérance, ce qui donne une borne inférieure.
Il reste à réécrire le quotient. Par la propriété de Markov puis la formule de Bayes, q(\mathbf{y}_k \mid \mathbf{y}_{k-1}) = q(\mathbf{y}_k \mid \mathbf{y}_{k-1}, \mathbf{y}_0) = q(\mathbf{y}_{k-1} \mid \mathbf{y}_k, \mathbf{y}_0)\,q(\mathbf{y}_k \mid \mathbf{y}_0)/q(\mathbf{y}_{k-1} \mid \mathbf{y}_0). Dans le produit sur k = 2, \dots, K, les quotients q(\mathbf{y}_k \mid \mathbf{y}_0)/q(\mathbf{y}_{k-1} \mid \mathbf{y}_0) se télescopent en q(\mathbf{y}_K \mid \mathbf{y}_0)/q(\mathbf{y}_1 \mid \mathbf{y}_0), d’où
q(\mathbf{y}_{1:K} \mid \mathbf{y}_0) = q(\mathbf{y}_K \mid \mathbf{y}_0)\prod_{k=2}^K q(\mathbf{y}_{k-1} \mid \mathbf{y}_k, \mathbf{y}_0).
En divisant p_\theta(\mathbf{y}_{0:K}) = p(\mathbf{y}_K)\prod_{k=1}^K p_\theta(\mathbf{y}_{k-1} \mid \mathbf{y}_k) par cette expression et en prenant l’opposé de l’espérance du logarithme, on obtient terme à terme L_K, la somme des L_{k-1} (chaque terme est l’espérance d’un logarithme de quotient de densités, c’est-à-dire une divergence de Kullback–Leibler) et L_0. ∎
Chaque terme L_{k-1} compare deux gaussiennes. Quand les variances sont fixées, la divergence entre \mathcal{N}(\mathbf{a}, \tilde\beta I) et \mathcal{N}(\mathbf{b}, \sigma^2 I) vaut \|\mathbf{a} - \mathbf{b}\|^2/(2\sigma^2) plus une constante qui ne dépend que des variances. Il suffit donc que \mathbf{m}_\theta apprenne la moyenne a posteriori \tilde{\boldsymbol\mu}_k. Le bon choix de paramétrisation est de prédire le bruit.
Proposition 2.8 — Prédiction du bruit En écrivant \mathbf{y}_k = \sqrt{\bar\alpha_k}\,\mathbf{y}_0 + \sqrt{1 - \bar\alpha_k}\,\boldsymbol\varepsilon, la moyenne a posteriori s’exprime sans \mathbf{y}_0 :
\tilde{\boldsymbol\mu}_k = \frac{1}{\sqrt{\alpha_k}}\Big(\mathbf{y}_k - \frac{\beta_k}{\sqrt{1 - \bar\alpha_k}}\,\boldsymbol\varepsilon\Big).
Avec la paramétrisation \mathbf{m}_\theta(\mathbf{y}_k, k) = \frac{1}{\sqrt{\alpha_k}}\big(\mathbf{y}_k - \frac{\beta_k}{\sqrt{1 - \bar\alpha_k}}\,\boldsymbol\varepsilon_\theta(\mathbf{y}_k, k)\big), le terme L_{k-1}, moyenné sur la donnée \mathbf{y}_0 \sim \mu, devient, à une constante près,
L_{k-1} = \frac{\beta_k^2}{2\sigma_k^2\,\alpha_k(1 - \bar\alpha_k)}\;\mathbb{E}_{\mathbf{y}_0, \boldsymbol\varepsilon}\Big\|\boldsymbol\varepsilon - \boldsymbol\varepsilon_\theta\big(\sqrt{\bar\alpha_k}\,\mathbf{y}_0 + \sqrt{1 - \bar\alpha_k}\,\boldsymbol\varepsilon,\; k\big)\Big\|^2.
Preuve. On remplace \mathbf{y}_0 = (\mathbf{y}_k - \sqrt{1 - \bar\alpha_k}\,\boldsymbol\varepsilon)/\sqrt{\bar\alpha_k} dans \tilde{\boldsymbol\mu}_k (proposition 2.5). Comme \sqrt{\bar\alpha_{k-1}}/\sqrt{\bar\alpha_k} = 1/\sqrt{\alpha_k}, le coefficient de \mathbf{y}_k vaut \frac{\beta_k + \alpha_k(1 - \bar\alpha_{k-1})}{(1 - \bar\alpha_k)\sqrt{\alpha_k}} = \frac{1}{\sqrt{\alpha_k}}, et celui de \boldsymbol\varepsilon vaut -\frac{\beta_k\sqrt{1 - \bar\alpha_k}}{(1 - \bar\alpha_k)\sqrt{\alpha_k}} = -\frac{\beta_k}{\sqrt{\alpha_k}\sqrt{1 - \bar\alpha_k}}. Avec la paramétrisation proposée, \tilde{\boldsymbol\mu}_k - \mathbf{m}_\theta = \frac{\beta_k}{\sqrt{\alpha_k(1 - \bar\alpha_k)}}(\boldsymbol\varepsilon_\theta - \boldsymbol\varepsilon), et l’on divise le carré de sa norme par 2\sigma_k^2. ∎
Définition 2.9 — Perte simplifiée de DDPM Ho et al. (2020) abandonnent les poids de la proposition 2.8 et entraînent avec
L_{\mathrm{simple}}(\theta) = \mathbb{E}_{k \sim \mathcal{U}\{1, \dots, K\},\; \mathbf{y}_0 \sim \mu,\; \boldsymbol\varepsilon \sim \mathcal{N}(0, I)}\Big\|\boldsymbol\varepsilon - \boldsymbol\varepsilon_\theta\big(\sqrt{\bar\alpha_k}\,\mathbf{y}_0 + \sqrt{1 - \bar\alpha_k}\,\boldsymbol\varepsilon,\; k\big)\Big\|^2.
L’entraînement est une simple régression : on tire une donnée, un instant et un bruit, on fabrique \mathbf{y}_k en une ligne, et le réseau apprend à retrouver le bruit. Aucune simulation de la chaîne n’est nécessaire. Avec cette perte, Ho et al. (2020) obtiennent un FID de 3{,}17 et un score Inception de 9{,}46 sur CIFAR-10 non conditionnel.
2.4 Échantillonnage
Algorithme 2.10 — Échantillonnage ancestral de DDPM Tirer \mathbf{y}_K \sim \mathcal{N}(0, I). Pour k = K, \dots, 1 : tirer \mathbf{z} \sim \mathcal{N}(0, I) si k > 1, sinon \mathbf{z} = 0, puis poser
\mathbf{y}_{k-1} = \frac{1}{\sqrt{\alpha_k}}\Big(\mathbf{y}_k - \frac{\beta_k}{\sqrt{1 - \bar\alpha_k}}\,\boldsymbol\varepsilon_\theta(\mathbf{y}_k, k)\Big) + \sigma_k\,\mathbf{z}.
Renvoyer \mathbf{y}_0.
L’échantillonnage coûte K évaluations du réseau, soit 1000 dans l’article original. Song, Meng et Ermon (2021) ont montré qu’avec le même réseau, un échantillonneur déterministe (DDIM) obtient des échantillons de qualité comparable en beaucoup moins de pas : à chaque pas, on calcule l’estimée débruitée \hat{\mathbf{y}}_0 = (\mathbf{y}_k - \sqrt{1 - \bar\alpha_k}\,\boldsymbol\varepsilon_\theta)/\sqrt{\bar\alpha_k} puis on la « re-bruite » au niveau suivant k' avec le bruit prédit, \mathbf{y}_{k'} = \sqrt{\bar\alpha_{k'}}\,\hat{\mathbf{y}}_0 + \sqrt{1 - \bar\alpha_{k'}}\,\boldsymbol\varepsilon_\theta. Le chapitre 3 montre que DDIM discrétise une équation différentielle ordinaire.
Exemple 2.11 — Vérification numérique des propositions 2.2 et 2.5 Le bloc suivant calcule le planning de Ho et al., simule la chaîne directe sur des données à deux points \pm 1, puis vérifie que le bruit reconstruit \boldsymbol\varepsilon = (\mathbf{y}_k - \sqrt{\bar\alpha_k}\,\mathbf{y}_0)/\sqrt{1 - \bar\alpha_k} est gaussien centré réduit et indépendant de la donnée, et que le résidu \mathbf{y}_{k-1} - \tilde{\boldsymbol\mu}_k a bien la variance \tilde\beta_k (et non \beta_k).
import numpy as np

K = 1000
beta = np.linspace(1e-4, 0.02, K)            # planning linéaire de Ho et al. (2020)
alpha = 1 - beta
abar = np.cumprod(alpha)                     # ᾱ_k = ∏_{j ≤ k} (1 - β_j)  (indice Python k-1)
snr = abar / (1 - abar)                      # rapport signal sur bruit
print(f"ᾱ_K = {abar[-1]:.2e}")
for k in [1, 10, 100, 250, 500, 1000]:
    print(f"k = {k:4d} : ᾱ_k = {abar[k-1]:.4f}, RSB = {snr[k-1]:.3e}")

rng = np.random.default_rng(0)
n = 400_000
y0 = rng.choice([-1.0, 1.0], size=n)          # données à deux points ±1

def chaine(k):
    """Simule la chaîne directe ; renvoie (y_{k-1}, y_k)."""
    y = y0.copy()
    for j in range(k - 1):
        y = np.sqrt(alpha[j]) * y + np.sqrt(beta[j]) * rng.standard_normal(n)
    return y, np.sqrt(alpha[k-1]) * y + np.sqrt(beta[k-1]) * rng.standard_normal(n)

# Loi marginale (Prop. 2.2) : ε = (y_k - √ᾱ_k y0)/√(1-ᾱ_k) doit être N(0,1) et indépendant de y0
_, yk = chaine(300)
eps = (yk - np.sqrt(abar[299]) * y0) / np.sqrt(1 - abar[299])
print(f"k = 300, ε : moyenne {eps.mean():+.4f}, variance {eps.var():.4f}, corr(ε, y0) = {np.corrcoef(eps, y0)[0,1]:+.4f}")

# Loi a posteriori q(y_{k-1} | y_k, y0) (Prop. 2.5), à k = 10 où β̃_k et β_k diffèrent nettement
k = 10
yprec, yk = chaine(k)
c0 = np.sqrt(abar[k-2]) * beta[k-1] / (1 - abar[k-1])
ck = np.sqrt(alpha[k-1]) * (1 - abar[k-2]) / (1 - abar[k-1])
beta_t = (1 - abar[k-2]) / (1 - abar[k-1]) * beta[k-1]
r = yprec - (c0 * y0 + ck * yk)
print(f"k = 10, résidu : moyenne {r.mean():+.1e}, variance {r.var():.4e} ; β̃_k = {beta_t:.4e}, β_k = {beta[k-1]:.4e}")
# sortie :
# ᾱ_K = 4.04e-05
# k =    1 : ᾱ_k = 0.9999, RSB = 9.999e+03
# k =   10 : ᾱ_k = 0.9981, RSB = 5.268e+02
# k =  100 : ᾱ_k = 0.8970, RSB = 8.710e+00
# k =  250 : ᾱ_k = 0.5241, RSB = 1.101e+00
# k =  500 : ᾱ_k = 0.0786, RSB = 8.529e-02
# k = 1000 : ᾱ_k = 0.0000, RSB = 4.036e-05
# k = 300, ε : moyenne +0.0025, variance 1.0025, corr(ε, y0) = -0.0021
# k = 10, résidu : moyenne +1.0e-05, variance 2.3764e-04 ; β̃_k = 2.3818e-04, β_k = 2.7928e-04
La variance mesurée du résidu, 2{,}376 \times 10^{-4}, est à 0{,}2 % de \tilde\beta_{10} = 2{,}382 \times 10^{-4} et à 15 % de \beta_{10} : c’est bien la variance a posteriori qui gouverne le pas inverse quand la donnée est connue. Le bruit reconstruit est centré, de variance 1 et décorrélé de \mathbf{y}_0, aux fluctuations d’échantillonnage près (\pm 0{,}003 pour 4 \times 10^5 tirages).
Ce qu’il faut retenir — chapitre 2
- Le bruitage gaussien a une loi marginale explicite : \mathbf{y}_k = \sqrt{\bar\alpha_k}\,\mathbf{y}_0 + \sqrt{1 - \bar\alpha_k}\,\boldsymbol\varepsilon ; on tire \mathbf{y}_k en une ligne.
- Sachant la donnée, un pas inverse est gaussien de moyenne \tilde{\boldsymbol\mu}_k et de variance \tilde\beta_k ; la borne variationnelle se réduit à faire apprendre cette moyenne.
- Paramétrer la moyenne par le bruit prédit \boldsymbol\varepsilon_\theta transforme l’entraînement en une régression : L_{\mathrm{simple}} = \mathbb{E}\|\boldsymbol\varepsilon - \boldsymbol\varepsilon_\theta(\mathbf{y}_k, k)\|^2.
- L’échantillonnage ancestral coûte K évaluations du réseau ; DDIM réutilise le même réseau avec beaucoup moins de pas.
3. La vue continue : EDS, score et flot de probabilité
Quand le nombre de pas K tend vers l’infini, la chaîne de DDPM devient une équation différentielle stochastique (EDS). Ce passage à la limite, systématisé par Song et al. (2021), a trois intérêts : il montre que toute la diffusion repose sur un seul objet, le score \nabla\log p_s ; il fournit une équation différentielle ordinaire qui a les mêmes lois marginales, donc un échantillonneur déterministe ; il sépare proprement les choix de modélisation (planning, paramétrisation, solveur), ce qu’exploite EDM (Karras et al., 2022).
3.1 De la chaîne à l’équation différentielle stochastique
Posons s_k = k/K et \beta_k = \beta(s_k)/K pour une fonction continue \beta(s) > 0. Comme \sqrt{1 - \beta_k} \approx 1 - \beta_k/2, un pas de la chaîne s’écrit \mathbf{y}_k - \mathbf{y}_{k-1} \approx -\tfrac12\beta(s_k)\,\mathbf{y}_{k-1}\,\Delta s + \sqrt{\beta(s_k)\,\Delta s}\;\boldsymbol\varepsilon_k avec \Delta s = 1/K : c’est un pas du schéma d’Euler–Maruyama d’une EDS.
Définition 3.1 — EDS directe Le processus de bruitage continu est la solution de
\mathrm{d}\mathbf{y}_s = f(\mathbf{y}_s, s)\,\mathrm{d}s + g(s)\,\mathrm{d}W_s, \qquad s \in [0, 1], \qquad \mathbf{y}_0 \sim \mu,
où W est un mouvement brownien de \mathbb{R}^D. On note p_s la densité de \mathbf{y}_s. Deux choix classiques (Song et al., 2021) : l’EDS à variance préservée (VP), limite de DDPM, avec f = -\tfrac12\beta(s)\mathbf{y} et g = \sqrt{\beta(s)} ; l’EDS à variance explosive (VE), avec f = 0 et g = \sqrt{\mathrm{d}[\sigma^2(s)]/\mathrm{d}s}, qui ajoute simplement un bruit de variance \sigma^2(s).
Proposition 3.2 — Lois marginales de l’EDS VP Pour l’EDS VP, \mathbf{y}_s \mid \mathbf{y}_0 \sim \mathcal{N}\big(a(s)\,\mathbf{y}_0,\; \sigma(s)^2 I\big) avec a(s) = \exp\big(-\tfrac12\int_0^s\beta(r)\,\mathrm{d}r\big) et \sigma(s)^2 = 1 - a(s)^2.
Preuve. Notons B(s) = \int_0^s \beta. La formule d’Itô appliquée à e^{B(s)/2}\,\mathbf{y}_s (fonction linéaire de \mathbf{y}, donc sans terme de dérivée seconde) donne \mathrm{d}\big(e^{B/2}\mathbf{y}_s\big) = e^{B/2}\big(\tfrac12\beta\,\mathbf{y}_s\,\mathrm{d}s + \mathrm{d}\mathbf{y}_s\big) = e^{B/2}\sqrt{\beta}\,\mathrm{d}W_s. En intégrant, \mathbf{y}_s = e^{-B(s)/2}\mathbf{y}_0 + \int_0^s e^{-(B(s) - B(r))/2}\sqrt{\beta(r)}\,\mathrm{d}W_r. L’intégrale stochastique d’une fonction déterministe est gaussienne centrée ; par l’isométrie d’Itô, sa variance vaut \int_0^s e^{-(B(s) - B(r))}\beta(r)\,\mathrm{d}r = \big[e^{-(B(s) - B(r))}\big]_{r=0}^{r=s} = 1 - e^{-B(s)}. ∎
La densité p_s obéit à l’équation de Fokker–Planck (module p4) :
\partial_s p_s = -\nabla\cdot(f\,p_s) + \frac{g^2}{2}\,\Delta p_s.
Toute la suite repose sur une identité élémentaire : \Delta p = \nabla\cdot(\nabla p) = \nabla\cdot(p\,\nabla\log p).
3.2 Remonter le temps : EDS inverse et ODE de flot de probabilité
Théorème 3.3 — EDS inverse (Anderson, 1982 ; Song et al., 2021) Notons \tau = 1 - s le temps inversé. Le processus \bar{\mathbf{y}}_\tau solution de
\mathrm{d}\bar{\mathbf{y}}_\tau = \Big[-f(\bar{\mathbf{y}}_\tau, 1 - \tau) + g(1 - \tau)^2\,\nabla\log p_{1-\tau}(\bar{\mathbf{y}}_\tau)\Big]\mathrm{d}\tau + g(1 - \tau)\,\mathrm{d}\bar W_\tau, \qquad \bar{\mathbf{y}}_0 \sim p_1,
a pour loi au temps \tau la loi p_{1-\tau} du processus direct au temps s = 1 - \tau. En particulier \bar{\mathbf{y}}_1 \sim \mu.
Preuve. Esquisse, au niveau des lois marginales (Anderson démontre l’égalité des lois des trajectoires entières). Posons q_\tau = p_{1-\tau}. Par Fokker–Planck, \partial_\tau q_\tau = -(\partial_s p)_{s = 1 - \tau} = \nabla\cdot(f\,q_\tau) - \frac{g^2}{2}\Delta q_\tau. On cherche une dérive b telle que cette équation soit l’équation de Fokker–Planck d’une EDS de coefficient de diffusion g, c’est-à-dire \partial_\tau q = -\nabla\cdot(b\,q) + \frac{g^2}{2}\Delta q. Il faut -\nabla\cdot(b\,q) = \nabla\cdot(f\,q) - g^2\Delta q = \nabla\cdot\big(f\,q - g^2 q\,\nabla\log q\big), ce que réalise b = -f + g^2\,\nabla\log q. Les deux équations de Fokker–Planck coïncident et partent de la même loi q_0 = p_1 ; par unicité de la solution (admise), les lois marginales coïncident à tout instant. ∎
Proposition 3.4 — ODE de flot de probabilité L’équation différentielle ordinaire
\frac{\mathrm{d}\mathbf{y}}{\mathrm{d}s} = f(\mathbf{y}, s) - \frac12\,g(s)^2\,\nabla\log p_s(\mathbf{y})
transporte p_0 = \mu sur p_s pour tout s. Intégrée à rebours depuis \mathbf{y}_1 \sim p_1 \approx \mathcal{N}(0, I), elle produit des échantillons de \mu de façon déterministe.
Preuve. Avec l’identité \Delta p = \nabla\cdot(p\nabla\log p), l’équation de Fokker–Planck devient \partial_s p_s = -\nabla\cdot\big[\big(f - \tfrac12 g^2\nabla\log p_s\big)\,p_s\big]. C’est l’équation de continuité (théorème 4.2) du champ de vitesse f - \tfrac12 g^2\nabla\log p_s : la densité p_s est transportée par le flot de ce champ. ∎
L’EDS inverse et l’ODE de flot ont les mêmes lois marginales, mais pas les mêmes trajectoires : l’EDS ajoute du bruit qui peut corriger certaines erreurs, l’ODE est déterministe, bijective, permet de calculer la vraisemblance par la proposition 1.12 et se prête aux solveurs d’ordre élevé. Dans les deux cas, il suffit de connaître le score \nabla\log p_s à tous les niveaux de bruit.
3.3 Le score et son apprentissage
Définition 3.5 — Score et score matching explicite Le score d’une densité p est le champ de vecteurs \nabla\log p. Il ne dépend pas de la constante de normalisation de p. Le score matching explicite cherche un réseau s_\theta qui minimise
J_{\mathrm{ESM}}(\theta) = \mathbb{E}_{\mathbf{y} \sim p}\big\|s_\theta(\mathbf{y}) - \nabla\log p(\mathbf{y})\big\|^2.
Cette perte est inutilisable telle quelle, puisque \nabla\log p est précisément inconnu. Hyvärinen (2005) a montré qu’une intégration par parties la réécrit, à une constante près, comme \mathbb{E}_p\big[2\,\mathrm{tr}\,\nabla s_\theta + \|s_\theta\|^2\big] (exercice 7), mais la trace de la jacobienne coûte D rétropropagations. La solution adoptée par tous les modèles de diffusion est due à Vincent (2011) : bruiter les données et apprendre à débruiter.
Théorème 3.6 — Équivalence de Vincent (2011) Soit q_\sigma(\mathbf{y} \mid \mathbf{y}_0) une densité de bruitage régulière et p_\sigma(\mathbf{y}) = \int q_\sigma(\mathbf{y} \mid \mathbf{y}_0)\,\mu(\mathrm{d}\mathbf{y}_0) la loi des données bruitées. On définit la perte de score matching par débruitage
J_{\mathrm{DSM}}(\theta) = \mathbb{E}_{\mathbf{y}_0 \sim \mu,\; \mathbf{y} \sim q_\sigma(\cdot \mid \mathbf{y}_0)}\big\|s_\theta(\mathbf{y}) - \nabla_{\mathbf{y}}\log q_\sigma(\mathbf{y} \mid \mathbf{y}_0)\big\|^2.
Alors J_{\mathrm{DSM}}(\theta) = J_{\mathrm{ESM}}(\theta) + C, où J_{\mathrm{ESM}} est calculée pour p = p_\sigma et C ne dépend pas de \theta. Les deux pertes ont donc les mêmes minimiseurs et les mêmes gradients.
Preuve. On développe les deux carrés. Dans J_{\mathrm{ESM}} : \mathbb{E}_{p_\sigma}\|s_\theta\|^2 - 2\,\mathbb{E}_{p_\sigma}[s_\theta\cdot\nabla\log p_\sigma] + C_1. Dans J_{\mathrm{DSM}} : \mathbb{E}\|s_\theta(\mathbf{y})\|^2 - 2\,\mathbb{E}[s_\theta(\mathbf{y})\cdot\nabla_{\mathbf{y}}\log q_\sigma(\mathbf{y} \mid \mathbf{y}_0)] + C_2. Les constantes C_1 = \mathbb{E}\|\nabla\log p_\sigma\|^2 et C_2 = \mathbb{E}\|\nabla\log q_\sigma\|^2 ne dépendent pas de \theta. Les premiers termes sont égaux, car la loi marginale de \mathbf{y} est p_\sigma. Pour les termes croisés, en dérivant sous l’intégrale :
\mathbb{E}_{p_\sigma}[s_\theta\cdot\nabla\log p_\sigma] = \int s_\theta(\mathbf{y})\cdot\nabla p_\sigma(\mathbf{y})\,\mathrm{d}\mathbf{y} = \iint s_\theta(\mathbf{y})\cdot\nabla_{\mathbf{y}} q_\sigma(\mathbf{y} \mid \mathbf{y}_0)\,\mu(\mathrm{d}\mathbf{y}_0)\,\mathrm{d}\mathbf{y}.
On écrit \nabla_{\mathbf{y}} q_\sigma = q_\sigma\,\nabla_{\mathbf{y}}\log q_\sigma : la dernière intégrale est exactement \mathbb{E}[s_\theta(\mathbf{y})\cdot\nabla_{\mathbf{y}}\log q_\sigma(\mathbf{y} \mid \mathbf{y}_0)] sous la loi jointe de (\mathbf{y}_0, \mathbf{y}). Les termes croisés sont égaux, d’où J_{\mathrm{DSM}} - J_{\mathrm{ESM}} = C_2 - C_1. ∎
À retenir — débruiter, c’est apprendre le score Pour un bruitage gaussien \mathbf{y} = a\,\mathbf{y}_0 + \sigma\boldsymbol\varepsilon, on a \nabla_{\mathbf{y}}\log q_\sigma(\mathbf{y} \mid \mathbf{y}_0) = -(\mathbf{y} - a\mathbf{y}_0)/\sigma^2 = -\boldsymbol\varepsilon/\sigma, donc
J_{\mathrm{DSM}}(\theta) = \frac{1}{\sigma^2}\,\mathbb{E}\big\|\boldsymbol\varepsilon - \boldsymbol\varepsilon_\theta(\mathbf{y})\big\|^2,
où l’on a posé \boldsymbol\varepsilon_\theta = -\sigma\,s_\theta. La perte de DDPM (définition 2.9) est un score matching par débruitage, pondéré par \sigma^2 à chaque niveau de bruit, et le score appris est s_\theta(\mathbf{y}_k, k) = -\boldsymbol\varepsilon_\theta(\mathbf{y}_k, k)/\sqrt{1 - \bar\alpha_k}. C’est le lien entre DDPM et les modèles à score de Song & Ermon (2019).
La proposition suivante dit ce que représente le score : la direction vers la meilleure estimation de la donnée propre.
Proposition 3.7 — Formule de Tweedie (Efron, 2011) Si \mathbf{y} = a\,\mathbf{y}_0 + \sigma\boldsymbol\varepsilon avec \boldsymbol\varepsilon \sim \mathcal{N}(0, I) indépendant de \mathbf{y}_0 \sim \mu, et si p est la densité de \mathbf{y}, alors
\mathbb{E}[\mathbf{y}_0 \mid \mathbf{y}] = \frac{\mathbf{y} + \sigma^2\,\nabla\log p(\mathbf{y})}{a},
ce qui s’écrit aussi, pour le bruit,
\mathbb{E}[\boldsymbol\varepsilon \mid \mathbf{y}] = -\sigma\,\nabla\log p(\mathbf{y}).
Preuve. On a p(\mathbf{y}) = \int \mathcal{N}(\mathbf{y};\, a\mathbf{y}_0, \sigma^2 I)\,\mu(\mathrm{d}\mathbf{y}_0). En dérivant sous l’intégrale, \nabla\mathcal{N}(\mathbf{y};\, a\mathbf{y}_0, \sigma^2 I) = -\frac{\mathbf{y} - a\mathbf{y}_0}{\sigma^2}\,\mathcal{N}(\mathbf{y};\, a\mathbf{y}_0, \sigma^2 I), donc \nabla p(\mathbf{y}) = -\frac{1}{\sigma^2}\big(\mathbf{y}\,p(\mathbf{y}) - a\,\mathbb{E}[\mathbf{y}_0 \mid \mathbf{y}]\,p(\mathbf{y})\big), puisque \int \mathbf{y}_0\,\mathcal{N}(\mathbf{y};\, a\mathbf{y}_0, \sigma^2 I)\,\mu(\mathrm{d}\mathbf{y}_0) = \mathbb{E}[\mathbf{y}_0 \mid \mathbf{y}]\,p(\mathbf{y}) (formule de Bayes). On divise par p(\mathbf{y}) et on isole \mathbb{E}[\mathbf{y}_0 \mid \mathbf{y}]. La seconde forme s’obtient en prenant l’espérance conditionnelle de \boldsymbol\varepsilon = (\mathbf{y} - a\mathbf{y}_0)/\sigma. ∎
Le débruiteur optimal, au sens des moindres carrés, est l’espérance conditionnelle \mathbb{E}[\mathbf{y}_0 \mid \mathbf{y}] ; la formule de Tweedie dit qu’il se déduit du score, et réciproquement. Cette estimée débruitée reviendra au chapitre 5 pour guider l’échantillonnage.
Exemple 3.8 — Vérification numérique de l’équivalence de Vincent On prend des données unidimensionnelles \mu = \tfrac12\mathcal{N}(-2, 0{,}5^2) + \tfrac12\mathcal{N}(2, 0{,}5^2), bruitées par y = y_0 + \sigma\varepsilon avec \sigma = 1, et une famille de modèles s_\theta(y) = \theta_1 y + \theta_2\tanh y. Le score exact de p_\sigma est connu. Pour plusieurs \theta, on estime J_{\mathrm{ESM}} et J_{\mathrm{DSM}} par Monte-Carlo : leur différence doit être la même constante C = 1/\sigma^2 - \mathbb{E}[(\partial_y\log p_\sigma)^2].
import numpy as np

rng = np.random.default_rng(0)
# Données : ½ N(-2, 0,5²) + ½ N(2, 0,5²) ; bruit y = y0 + σ ε avec σ = 1
m, s, sig = 2.0, 0.5, 1.0
n = 2_000_000
y0 = rng.choice([-m, m], size=n) + s * rng.standard_normal(n)
eps = rng.standard_normal(n)
y = y0 + sig * eps

def score_exact(y):                  # ∇ log p_σ, p_σ = ½ N(-m, s²+σ²) + ½ N(m, s²+σ²)
    v = s**2 + sig**2
    return (-y + m * np.tanh(m * y / v)) / v

# Famille de modèles linéaire en θ : s_θ(y) = θ1 y + θ2 tanh(y)
def s_theta(th, y):
    return th[0] * y + th[1] * np.tanh(y)

print("   θ          J_ESM      J_DSM      J_DSM - J_ESM")
for th in [(0.0, 0.0), (-0.8, 1.5), (-0.5, 0.5), (-1.0, 3.0), (0.3, -1.0)]:
    st = s_theta(th, y)
    J_esm = np.mean((st - score_exact(y)) ** 2)
    J_dsm = np.mean((st + eps / sig) ** 2)          # ∇_y log q(y|y0) = -(y - y0)/σ² = -ε/σ
    print(f"{str(th):12s} {J_esm:9.4f} {J_dsm:10.4f} {J_dsm - J_esm:12.4f}")
print("constante théorique 1/σ² - E[(∇log p_σ)²] =", round(1 / sig**2 - np.mean(score_exact(y) ** 2), 4))
# sortie :
#    θ          J_ESM      J_DSM      J_DSM - J_ESM
# (0.0, 0.0)      0.5175     1.0003       0.4827
# (-0.8, 1.5)     0.0422     0.5249       0.4827
# (-0.5, 0.5)     0.2675     0.7499       0.4824
# (-1.0, 3.0)     0.5558     1.0394       0.4835
# (0.3, -1.0)     0.8161     1.2986       0.4824
# constante théorique 1/σ² - E[(∇log p_σ)²] = 0.4825
L’erreur sur le score J_{\mathrm{ESM}} varie d’un facteur vingt d’un modèle à l’autre (et J_{\mathrm{DSM}} d’un facteur deux et demi), mais la différence des deux pertes reste égale à 0{,}483 \pm 0{,}001, la constante prédite. Minimiser la perte de débruitage, calculable, revient donc exactement à minimiser l’erreur sur le score, incalculable.
3.4 EDM : séparer les choix de conception
Karras et al. (2022) réécrivent la diffusion dans la paramétrisation la plus simple possible, dite VE : \mathbf{y} = \mathbf{x} + \sigma\mathbf{n}, où \mathbf{x} est une donnée, \mathbf{n} \sim \mathcal{N}(0, I), et le niveau de bruit \sigma sert lui-même de temps. On note D(\mathbf{y}; \sigma) = \mathbb{E}[\mathbf{x} \mid \mathbf{y}] le débruiteur idéal ; par Tweedie (avec a = 1), \nabla\log p(\mathbf{y}; \sigma) = (D(\mathbf{y}; \sigma) - \mathbf{y})/\sigma^2, et l’ODE de flot de probabilité (proposition 3.4 avec f = 0, g^2 = \mathrm{d}\sigma^2/\mathrm{d}\sigma = 2\sigma) prend la forme
\frac{\mathrm{d}\mathbf{y}}{\mathrm{d}\sigma} = -\sigma\,\nabla\log p(\mathbf{y}; \sigma) = \frac{\mathbf{y} - D(\mathbf{y}; \sigma)}{\sigma}.
On l’intègre de \sigma_{\max} à 0 en partant de \mathbf{y} \sim \mathcal{N}(0, \sigma_{\max}^2 I). Les choix d’EDM, tous tirés du tableau 1 de l’article, sont les suivants.
- Solveur : méthode de Heun d’ordre 2 (une prédiction d’Euler suivie d’une correction par la règle des trapèzes), avec un pas d’Euler pour le dernier intervalle vers \sigma = 0.
- Niveaux de bruit : \sigma_i = \big(\sigma_{\max}^{1/\rho} + \tfrac{i}{N-1}(\sigma_{\min}^{1/\rho} - \sigma_{\max}^{1/\rho})\big)^\rho pour i < N, \sigma_N = 0, avec \sigma_{\min} = 0{,}002, \sigma_{\max} = 80, \rho = 7 : les pas sont resserrés près des faibles bruits, là où les erreurs coûtent le plus.
- Préconditionnement : D_\theta(\mathbf{y}; \sigma) = c_{\mathrm{skip}}(\sigma)\,\mathbf{y} + c_{\mathrm{out}}(\sigma)\,F_\theta\big(c_{\mathrm{in}}(\sigma)\,\mathbf{y};\, c_{\mathrm{noise}}(\sigma)\big), avec c_{\mathrm{skip}} = \sigma_{\mathrm{d}}^2/(\sigma^2 + \sigma_{\mathrm{d}}^2), c_{\mathrm{out}} = \sigma\sigma_{\mathrm{d}}/\sqrt{\sigma^2 + \sigma_{\mathrm{d}}^2}, c_{\mathrm{in}} = 1/\sqrt{\sigma^2 + \sigma_{\mathrm{d}}^2}, c_{\mathrm{noise}} = \tfrac14\ln\sigma et \sigma_{\mathrm{d}} = 0{,}5 l’écart-type des données.
- Entraînement : \ln\sigma \sim \mathcal{N}(P_{\mathrm{mean}}, P_{\mathrm{std}}^2) avec P_{\mathrm{mean}} = -1{,}2 et P_{\mathrm{std}} = 1{,}2, et un poids \lambda(\sigma) = (\sigma^2 + \sigma_{\mathrm{d}}^2)/(\sigma\sigma_{\mathrm{d}})^2.
Avec ces choix, EDM atteint un FID de 1{,}79 (conditionnel) et 1{,}97 (non conditionnel) sur CIFAR-10 avec seulement 35 évaluations du réseau par image (Karras et al., 2022). Les coefficients de préconditionnement ne sont pas empiriques : ils normalisent entrée et cible du réseau.
Proposition 3.9 — Rôle du préconditionnement d’EDM Supposons les composantes de \mathbf{x} centrées, de variance \sigma_{\mathrm{d}}^2, et \mathbf{n} indépendant de \mathbf{x}. Alors chaque composante de c_{\mathrm{in}}\mathbf{y} est de variance 1, et la cible effective du réseau, (\mathbf{x} - c_{\mathrm{skip}}\mathbf{y})/c_{\mathrm{out}}, aussi.
Preuve. On a \mathrm{Var}(y_i) = \sigma_{\mathrm{d}}^2 + \sigma^2, d’où la première affirmation. Ensuite, \mathbf{x} - c_{\mathrm{skip}}\mathbf{y} = (1 - c_{\mathrm{skip}})\mathbf{x} - c_{\mathrm{skip}}\sigma\mathbf{n} avec 1 - c_{\mathrm{skip}} = \sigma^2/(\sigma^2 + \sigma_{\mathrm{d}}^2). Sa variance par composante vaut \frac{\sigma^4\sigma_{\mathrm{d}}^2 + \sigma_{\mathrm{d}}^4\sigma^2}{(\sigma^2 + \sigma_{\mathrm{d}}^2)^2} = \frac{\sigma^2\sigma_{\mathrm{d}}^2}{\sigma^2 + \sigma_{\mathrm{d}}^2} = c_{\mathrm{out}}^2. ∎
Exemple 3.10 — Échantillonner avec le débruiteur exact Pour séparer les erreurs d’apprentissage des erreurs d’intégration, on utilise un débruiteur exact : pour un mélange de gaussiennes unidimensionnel, D(y; \sigma) = \mathbb{E}[x \mid y] se calcule en forme close. On compare l’ODE de flot intégrée par Heun sur la grille d’EDM et l’EDS inverse intégrée par Euler–Maruyama, à l’aide de la distance d’énergie \mathcal{E} définie au chapitre 7 (nulle si et seulement si les deux lois coïncident ; son estimateur sans biais fluctue autour de 0 quand elles coïncident).
import numpy as np

rng = np.random.default_rng(1)
# Données : mélange 1D  0,3 N(-2, 0,5²) + 0,7 N(2, 0,5²)
pi, mu, s = np.array([0.3, 0.7]), np.array([-2.0, 2.0]), 0.5

def donnees(n):
    return np.where(rng.random(n) < pi[0], mu[0], mu[1]) + s * rng.standard_normal(n)

def debruiteur(y, sig):
    """D(y; σ) = E[x | x + σ n = y], calculé exactement pour le mélange (formule de Tweedie)."""
    v = s**2 + sig**2
    logw = np.log(pi) - 0.5 * (y[:, None] - mu) ** 2 / v
    w = np.exp(logw - logw.max(1, keepdims=True)); w /= w.sum(1, keepdims=True)
    return (w * (s**2 * y[:, None] + sig**2 * mu) / v).sum(1)

def niveaux(N, smin=0.002, smax=80.0, rho=7.0):     # pas de Karras et al. (2022), éq. (5)
    i = np.arange(N)
    sig = (smax ** (1/rho) + i / (N - 1) * (smin ** (1/rho) - smax ** (1/rho))) ** rho
    return np.append(sig, 0.0)

def ode_heun(n, N):
    sg = niveaux(N); y = sg[0] * rng.standard_normal(n); nfe = 0
    for i in range(N):
        d = (y - debruiteur(y, sg[i])) / sg[i]; nfe += 1        # dy/dσ = (y - D)/σ
        y_new = y + (sg[i+1] - sg[i]) * d
        if sg[i+1] > 0:
            d2 = (y_new - debruiteur(y_new, sg[i+1])) / sg[i+1]; nfe += 1
            y_new = y + (sg[i+1] - sg[i]) * 0.5 * (d + d2)
        y = y_new
    return y, nfe

def eds_inverse(n, N):
    sg = niveaux(N); y = sg[0] * rng.standard_normal(n)
    for i in range(N):
        score = (debruiteur(y, sg[i]) - y) / sg[i] ** 2
        dv = sg[i] ** 2 - sg[i+1] ** 2
        y = y + dv * score + np.sqrt(dv) * rng.standard_normal(n)   # Euler–Maruyama
    return y, N

def d_energie(x, y):           # U-statistique en 1D
    n, m = len(x), len(y)
    dxy = np.abs(x[:, None] - y[None, :]).mean()
    dxx = np.abs(x[:, None] - x[None, :]).sum() / (n * (n - 1))
    dyy = np.abs(y[:, None] - y[None, :]).sum() / (m * (m - 1))
    return 2 * dxy - dxx - dyy

n = 3000
ref = donnees(n)
print(f"plancher (deux jeux de données) : D_E = {d_energie(donnees(n), ref):+.4f}")
for nom, f, N in [("ODE, Heun", ode_heun, 18), ("ODE, Heun", ode_heun, 5),
                  ("EDS inverse", eds_inverse, 35), ("EDS inverse", eds_inverse, 500)]:
    x, nfe = f(n, N)
    print(f"{nom:12s} {nfe:4d} évaluations : D_E = {d_energie(x, ref):+.4f}, part du mode de droite = {np.mean(x > 0):.3f}")
# sortie :
# plancher (deux jeux de données) : D_E = +0.0003
# ODE, Heun      35 évaluations : D_E = -0.0008, part du mode de droite = 0.687
# ODE, Heun       9 évaluations : D_E = +0.4257, part du mode de droite = 0.676
# EDS inverse    35 évaluations : D_E = +0.0043, part du mode de droite = 0.672
# EDS inverse   500 évaluations : D_E = -0.0007, part du mode de droite = 0.699
Avec le débruiteur exact, l’ODE intégrée par Heun en 35 évaluations est indiscernable des données (sa distance d’énergie est au niveau du plancher de bruit), alors qu’avec 9 évaluations l’erreur d’intégration domine. L’EDS inverse a besoin de beaucoup plus de pas pour la même précision : son bruit doit être intégré finement. C’est la raison pour laquelle les échantillonneurs rapides sont presque toujours déterministes.
Ce qu’il faut retenir — chapitre 3
- Quand K \to \infty, DDPM devient l’EDS VP \mathrm{d}\mathbf{y} = -\tfrac12\beta\,\mathbf{y}\,\mathrm{d}s + \sqrt\beta\,\mathrm{d}W, de lois marginales gaussiennes explicites.
- L’EDS inverse (dérive -f + g^2\nabla\log p_s) et l’ODE de flot de probabilité (vitesse f - \tfrac12 g^2\nabla\log p_s) ont les mêmes lois marginales que le processus direct : tout repose sur le score.
- Équivalence de Vincent : J_{\mathrm{DSM}} = J_{\mathrm{ESM}} + C ; prédire le bruit, c’est apprendre le score, s_\theta = -\boldsymbol\varepsilon_\theta/\sigma.
- Tweedie : \mathbb{E}[\mathbf{y}_0 \mid \mathbf{y}] = (\mathbf{y} + \sigma^2\nabla\log p)/a ; le débruiteur optimal et le score sont la même information.
- EDM sépare planning, préconditionnement et solveur ; Heun sur une grille resserrée près de \sigma = 0 suffit avec quelques dizaines d’évaluations.
4. Flow matching, rectified flow et interpolants stochastiques
La diffusion construit le transport du bruit vers les données de façon indirecte, en inversant un bruitage. Le flow matching (Lipman et al., 2023), le rectified flow (Liu, Gong & Liu, 2023) et les interpolants stochastiques (Albergo & Vanden-Eijnden, 2023) le construisent directement : on choisit un chemin entre bruit et données, on apprend par régression le champ de vitesse qui le réalise, puis on intègre une EDO. C’est la méthode utilisée dans les expériences E1 et E2 du dépôt et par FunDiff, la référence principale de l’offre de stage. On revient ici à la convention du site : \mathbf{x}_0 \sim \mathcal{N}(0, I) est le bruit, \mathbf{x}_1 \sim \mu la donnée.
4.1 Champ de vitesse, flot et équation de continuité
Définition 4.1 — Flot d’un champ de vitesse Soit v : \mathbb{R}^D \times [0, 1] \to \mathbb{R}^D un champ de vitesse régulier (par exemple C^1 et globalement lipschitzien en \mathbf{x}). Son flot \phi_t est défini par \partial_t\phi_t(\mathbf{x}) = v(\phi_t(\mathbf{x}), t) et \phi_0(\mathbf{x}) = \mathbf{x}. Le chemin de probabilité engendré par v à partir de p_0 est p_t = (\phi_t)_\# p_0. Ne pas confondre ce champ v, qui vit dans l’espace des états \mathbb{R}^D, avec la vitesse physique \mathbf{u} du fluide.
Théorème 4.2 — Équation de continuité Le chemin p_t = (\phi_t)_\# p_0 vérifie l’équation de continuité \partial_t p_t + \nabla\cdot(p_t\,v) = 0 au sens faible : pour toute fonction test \varphi régulière à support compact,
\frac{\mathrm{d}}{\mathrm{d}t}\int \varphi\,\mathrm{d}p_t = \int \nabla\varphi\cdot v(\cdot, t)\,\mathrm{d}p_t.
Réciproquement (résultat admis), si un chemin (p_t) et un champ v assez régulier vérifient cette équation, alors p_t = (\phi_t)_\# p_0.
Preuve. On a \int \varphi\,\mathrm{d}p_t = \mathbb{E}[\varphi(\mathbf{x}_t)] avec \mathbf{x}_t = \phi_t(\mathbf{x}_0), \mathbf{x}_0 \sim p_0. Par la règle de dérivation des fonctions composées, \frac{\mathrm{d}}{\mathrm{d}t}\varphi(\mathbf{x}_t) = \nabla\varphi(\mathbf{x}_t)\cdot v(\mathbf{x}_t, t), quantité bornée car \varphi est à support compact et v continue ; le théorème de convergence dominée autorise à échanger dérivée et espérance. Si p_t a une densité régulière, une intégration par parties donne \int\nabla\varphi\cdot v\,p_t\,\mathrm{d}\mathbf{x} = -\int\varphi\,\nabla\cdot(p_t v)\,\mathrm{d}\mathbf{x}, d’où la forme forte. ∎
La forme faible ne fait intervenir aucune densité : elle reste valable pour des lois sans densité, ce qui servira en dimension infinie (chapitre 6).
4.2 Chemin conditionnel et champ marginal
L’idée du flow matching est de fixer le chemin avant d’apprendre quoi que ce soit, en interpolant entre un bruit et une donnée tirés indépendamment.
Définition 4.3 — Chemin linéaire et champ marginal Soient \mathbf{x}_0 \sim \mathcal{N}(0, I) et \mathbf{x}_1 \sim \mu indépendants. Pour t \in [0, 1], on pose
\mathbf{x}_t = (1 - t)\,\mathbf{x}_0 + t\,\mathbf{x}_1,
on note p_t la loi de \mathbf{x}_t (donc p_0 = \mathcal{N}(0, I) et p_1 = \mu) et l’on définit le champ de vitesse marginal
v_t(\mathbf{x}) = \mathbb{E}\big[\mathbf{x}_1 - \mathbf{x}_0 \,\big|\, \mathbf{x}_t = \mathbf{x}\big].
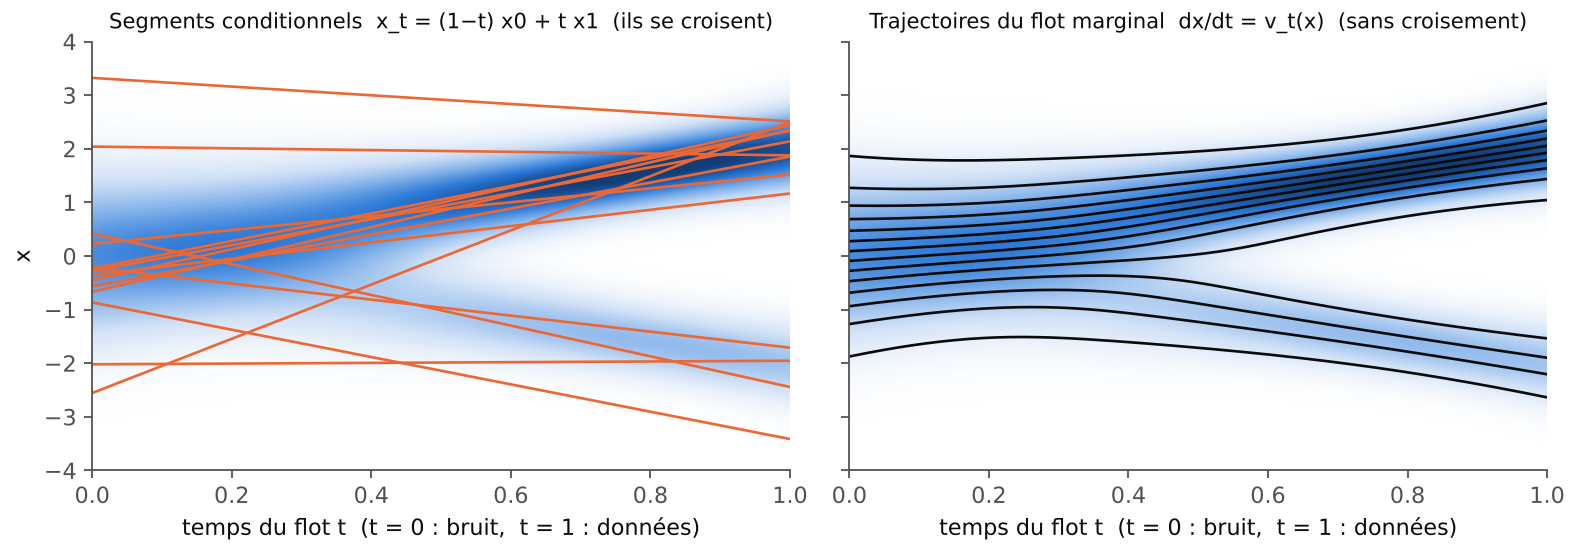
Chaque segment t \mapsto \mathbf{x}_t a une vitesse constante \mathbf{x}_1 - \mathbf{x}_0, la vitesse conditionnelle. Deux segments peuvent passer par le même point \mathbf{x} au même instant avec des vitesses différentes ; le champ marginal en fait la moyenne. Le théorème central dit que cette moyenne suffit.
Théorème 4.4 — Le champ marginal engendre le chemin Le couple (p_t, v_t) vérifie l’équation de continuité au sens faible. Par conséquent, si v_t est assez régulier, l’EDO \dot{\mathbf{x}} = v_t(\mathbf{x}) partie de \mathbf{x}(0) \sim \mathcal{N}(0, I) donne \mathbf{x}(t) \sim p_t pour tout t, et en particulier \mathbf{x}(1) \sim \mu.
Preuve. Pour une fonction test \varphi, on dérive \mathbb{E}[\varphi(\mathbf{x}_t)] le long des segments, puis on conditionne par \mathbf{x}_t (propriété de la tour de l’espérance conditionnelle) :
\frac{\mathrm{d}}{\mathrm{d}t}\mathbb{E}[\varphi(\mathbf{x}_t)] = \mathbb{E}\big[\nabla\varphi(\mathbf{x}_t)\cdot(\mathbf{x}_1 - \mathbf{x}_0)\big] = \mathbb{E}\Big[\nabla\varphi(\mathbf{x}_t)\cdot\mathbb{E}\big[\mathbf{x}_1 - \mathbf{x}_0 \,\big|\, \mathbf{x}_t\big]\Big] = \int \nabla\varphi\cdot v_t\,\mathrm{d}p_t.
C’est la forme faible de l’équation de continuité pour (p_t, v_t). La réciproque du théorème 4.2 conclut. ∎
Avec une source gaussienne, p_t a une densité strictement positive et lisse pour t < 1, et v_t est lisse ; des difficultés n’apparaissent qu’au voisinage de t = 1 lorsque les données sont très concentrées (par exemple sur une sous-variété), car v_t peut alors devenir très grand.
Proposition 4.5 — Lien avec la formulation de Lipman et al. (2023) Conditionnellement à \mathbf{x}_1, la loi de \mathbf{x}_t est p_t(\mathbf{x} \mid \mathbf{x}_1) = \mathcal{N}\big(t\,\mathbf{x}_1, (1 - t)^2 I\big) et la vitesse conditionnelle s’écrit u_t(\mathbf{x} \mid \mathbf{x}_1) = (\mathbf{x}_1 - \mathbf{x})/(1 - t). Le champ marginal en est la moyenne a posteriori :
v_t(\mathbf{x}) = \frac{1}{p_t(\mathbf{x})}\int u_t(\mathbf{x} \mid \mathbf{x}_1)\,p_t(\mathbf{x} \mid \mathbf{x}_1)\,\mu(\mathrm{d}\mathbf{x}_1).
Preuve. Si \mathbf{x}_t = \mathbf{x} et \mathbf{x}_1 sont connus, alors \mathbf{x}_0 = (\mathbf{x} - t\mathbf{x}_1)/(1 - t), donc \mathbf{x}_1 - \mathbf{x}_0 = (\mathbf{x}_1 - \mathbf{x})/(1 - t). La loi de \mathbf{x}_1 sachant \mathbf{x}_t = \mathbf{x} est p_t(\mathbf{x} \mid \mathbf{x}_1)\,\mu(\mathrm{d}\mathbf{x}_1)/p_t(\mathbf{x}) (formule de Bayes) ; on intègre la vitesse conditionnelle contre cette loi. ∎
Lipman et al. utilisent plus généralement p_t(\mathbf{x} \mid \mathbf{x}_1) = \mathcal{N}\big(t\mathbf{x}_1, (1 - (1 - \sigma_{\min})t)^2 I\big) avec un petit \sigma_{\min} > 0 qui évite la singularité en t = 1 (exercice 8), et montrent que les chemins de la diffusion sont des cas particuliers de chemins gaussiens conditionnels.
4.3 La perte de flow matching et le théorème des gradients
On voudrait faire apprendre v_t à un réseau v_\theta(\mathbf{x}, t), mais v_t est une espérance conditionnelle inconnue. La perte naturelle est donc incalculable ; la perte conditionnelle, elle, est calculable, et les deux ont le même gradient.
Définition 4.6 — Pertes marginale et conditionnelle Avec t \sim \mathcal{U}[0, 1], \mathbf{x}_0 \sim \mathcal{N}(0, I), \mathbf{x}_1 \sim \mu indépendants et \mathbf{x}_t = (1 - t)\mathbf{x}_0 + t\mathbf{x}_1 :
L_{\mathrm{FM}}(\theta) = \mathbb{E}_{t, \mathbf{x}_t}\big\|v_\theta(\mathbf{x}_t, t) - v_t(\mathbf{x}_t)\big\|^2,
L_{\mathrm{CFM}}(\theta) = \mathbb{E}_{t, \mathbf{x}_0, \mathbf{x}_1}\big\|v_\theta(\mathbf{x}_t, t) - (\mathbf{x}_1 - \mathbf{x}_0)\big\|^2.
Théorème 4.7 — Le gradient de la perte conditionnelle égale celui de la perte marginale Si \mathbb{E}\|\mathbf{x}_1\|^2 < \infty et \mathbb{E}\|v_\theta(\mathbf{x}_t, t)\|^2 < \infty, alors
L_{\mathrm{CFM}}(\theta) = L_{\mathrm{FM}}(\theta) + C, \qquad C = \mathbb{E}\big\|\mathbf{x}_1 - \mathbf{x}_0 - v_t(\mathbf{x}_t)\big\|^2,
où C ne dépend pas de \theta. En particulier \nabla_\theta L_{\mathrm{CFM}} = \nabla_\theta L_{\mathrm{FM}}, et le minimiseur de L_{\mathrm{CFM}} sur toutes les fonctions de carré intégrable est le champ marginal v_t (Lipman et al., 2023, théorème 2 ; Tong et al., 2024).
Preuve. Notons \mathbf{d} = \mathbf{x}_1 - \mathbf{x}_0. On insère v_t(\mathbf{x}_t) dans le carré :
\|v_\theta - \mathbf{d}\|^2 = \|v_\theta - v_t\|^2 + 2\,(v_\theta - v_t)\cdot(v_t - \mathbf{d}) + \|v_t - \mathbf{d}\|^2,
où v_\theta et v_t sont évalués en (\mathbf{x}_t, t). Pour le terme croisé, on conditionne par (t, \mathbf{x}_t) : le facteur v_\theta(\mathbf{x}_t, t) - v_t(\mathbf{x}_t) est alors fixé et sort de l’espérance conditionnelle, et \mathbb{E}[v_t(\mathbf{x}_t) - \mathbf{d} \mid t, \mathbf{x}_t] = v_t(\mathbf{x}_t) - \mathbb{E}[\mathbf{d} \mid t, \mathbf{x}_t] = 0 par définition de v_t. Le terme croisé est donc d’espérance nulle (les hypothèses d’intégrabilité et l’inégalité de Cauchy–Schwarz justifient les manipulations). En prenant l’espérance, il reste L_{\mathrm{CFM}} = L_{\mathrm{FM}} + C. Enfin L_{\mathrm{FM}} \ge 0 s’annule en v_\theta = v_t, qui minimise donc aussi L_{\mathrm{CFM}}. ∎
À retenir — la recette du flow matching On tire t, un bruit \mathbf{x}_0 et une donnée \mathbf{x}_1, on forme \mathbf{x}_t = (1 - t)\mathbf{x}_0 + t\mathbf{x}_1 et l’on régresse v_\theta(\mathbf{x}_t, t) sur \mathbf{x}_1 - \mathbf{x}_0. Le réseau apprend l’espérance conditionnelle, c’est-à-dire le champ marginal, qui transporte exactement le bruit sur les données. La perte ne tend pas vers 0 à l’optimum : elle tend vers la constante C > 0, la variance de la vitesse conditionnelle autour de sa moyenne.
La démonstration est la même que celle de l’équivalence de Vincent (théorème 3.6) : dans les deux cas, on remplace une cible inconnue (score ou vitesse marginale) par une cible conditionnelle bruitée dont elle est l’espérance conditionnelle, et l’on utilise que l’espérance conditionnelle est la projection orthogonale dans L^2.
Proposition 4.8 — Champ marginal pour un mélange de gaussiennes Si \mu = \sum_k \pi_k\,\mathcal{N}(\mathbf{m}_k, s^2 I), on note \sigma_t^2 = (1 - t)^2 + t^2 s^2. Alors p_t = \sum_k \pi_k\,\mathcal{N}(t\mathbf{m}_k, \sigma_t^2 I) et
v_t(\mathbf{x}) = \sum_k w_k(\mathbf{x}, t)\Big[\mathbf{m}_k + \frac{t s^2 - (1 - t)}{\sigma_t^2}\,(\mathbf{x} - t\mathbf{m}_k)\Big], \qquad w_k(\mathbf{x}, t) = \frac{\pi_k\,\mathcal{N}(\mathbf{x};\, t\mathbf{m}_k, \sigma_t^2 I)}{p_t(\mathbf{x})}.
Preuve. Conditionnellement à la composante k, le couple (\mathbf{x}_t, \mathbf{d}) avec \mathbf{d} = \mathbf{x}_1 - \mathbf{x}_0 est gaussien, de moyennes t\mathbf{m}_k et \mathbf{m}_k, de covariance de \mathbf{x}_t égale à \sigma_t^2 I, et de covariance croisée \mathrm{Cov}\big((1 - t)\mathbf{x}_0 + t\mathbf{x}_1,\; \mathbf{x}_1 - \mathbf{x}_0\big) = \big(t s^2 - (1 - t)\big) I. La formule du conditionnement gaussien, \mathbb{E}[\mathbf{d} \mid \mathbf{x}_t] = \mathbb{E}[\mathbf{d}] + \mathrm{Cov}(\mathbf{d}, \mathbf{x}_t)\,\mathrm{Var}(\mathbf{x}_t)^{-1}(\mathbf{x}_t - \mathbb{E}\mathbf{x}_t), donne le crochet. On moyenne ensuite sur les composantes avec leurs probabilités a posteriori w_k (formule des probabilités totales). ∎
Cette formule exacte permet de vérifier les théorèmes 4.4 et 4.7 sans aucun apprentissage. En t = 0, elle donne v_0(\mathbf{x}) = \sum_k\pi_k\mathbf{m}_k - \mathbf{x} ; en t = 1, v_1(\mathbf{x}) = \mathbf{x} : la donnée moins un bruit de moyenne nulle.
Exemple 4.9 — Continuité, transport et absence de croisement Pour la cible 0{,}3\,\mathcal{N}(-2, 0{,}5^2) + 0{,}7\,\mathcal{N}(2, 0{,}5^2), le bloc suivant vérifie l’équation de continuité par différences finies, transporte 2 \times 10^4 points gaussiens par l’EDO \dot x = v_t(x) (schéma de Heun, 100 pas) et contrôle que l’ordre des points est conservé.
import numpy as np

# Cible : mélange 1D  Σ π_k N(m_k, s²) ; source N(0, 1) ; chemin x_t = (1-t) x0 + t x1
pi, m, s = np.array([0.3, 0.7]), np.array([-2.0, 2.0]), 0.5

def p_et_v(x, t):
    """Densité p_t(x) et vitesse marginale v_t(x) = E[x1 - x0 | x_t = x] (proposition 4.8)."""
    var = (1 - t) ** 2 + t ** 2 * s ** 2                      # σ_t²
    g = pi * np.exp(-0.5 * (x[:, None] - t * m) ** 2 / var) / np.sqrt(2 * np.pi * var)
    p = g.sum(1)
    w = g / p[:, None]                                        # poids a posteriori des modes
    vk = m + (t * s ** 2 - (1 - t)) / var * (x[:, None] - t * m)
    return p, (w * vk).sum(1)

# 1) Équation de continuité ∂_t p + ∂_x (p v) = 0, vérifiée par différences finies
x = np.linspace(-5, 5, 2001); dx = x[1] - x[0]; dt = 1e-5
for t in [0.2, 0.5, 0.8, 0.95]:
    p, v = p_et_v(x, t)
    dpdt = (p_et_v(x, t + dt)[0] - p_et_v(x, t - dt)[0]) / (2 * dt)
    res = dpdt + np.gradient(p * v, dx)
    print(f"t = {t:4.2f} : max |∂t p + ∂x(pv)| / max |∂t p| = {np.abs(res).max() / np.abs(dpdt).max():.1e}")

# 2) Transport de N(0, 1) par l'EDO dx/dt = v_t(x), schéma de Heun à 100 pas
rng = np.random.default_rng(0)
x0 = rng.standard_normal(20_000); xt = x0.copy(); h = 1 / 100
for i in range(100):
    t = i * h
    d0 = p_et_v(xt, t)[1]
    d1 = p_et_v(xt + h * d0, min(t + h, 1 - 1e-9))[1]
    xt = xt + 0.5 * h * (d0 + d1)
print(f"part du mode de droite : {np.mean(xt > 0):.3f} (cible 0.700)")
print(f"moyenne {xt.mean():+.3f} (cible {pi @ m:+.3f}), variance {xt.var():.3f} (cible {pi @ (m**2) + s**2 - (pi @ m)**2:.3f})")
ordre = np.argsort(x0)
print("l'ordre des points est conservé (trajectoires sans croisement) :", bool(np.all(np.diff(xt[ordre]) > 0)))
# sortie :
# t = 0.20 : max |∂t p + ∂x(pv)| / max |∂t p| = 1.8e-05
# t = 0.50 : max |∂t p + ∂x(pv)| / max |∂t p| = 2.9e-05
# t = 0.80 : max |∂t p + ∂x(pv)| / max |∂t p| = 4.7e-05
# t = 0.95 : max |∂t p + ∂x(pv)| / max |∂t p| = 4.3e-05
# part du mode de droite : 0.699 (cible 0.700)
# moyenne +0.803 (cible +0.800), variance 3.596 (cible 3.610)
# l'ordre des points est conservé (trajectoires sans croisement) : True
Le résidu relatif de l’équation de continuité, de l’ordre de 10^{-5}, est l’erreur des différences finies : le champ marginal transporte bien le chemin. Les points poussés par l’EDO ont la moyenne, la variance et les poids de la cible aux fluctuations d’échantillonnage près, et leur ordre est conservé : en dimension 1, le flot marginal est une application croissante.
Le second bloc vérifie numériquement le théorème 4.7 avec un petit modèle linéaire en ses paramètres, v_\theta(x, t) = \theta\cdot(1, x, t, xt, \tanh x) : on calcule par différentiation automatique les gradients de L_{\mathrm{CFM}} (cible x_1 - x_0) et de L_{\mathrm{FM}} (cible exacte v_t de la proposition 4.8).
import torch

torch.manual_seed(0); torch.set_num_threads(1)
pi, m, s = torch.tensor([0.3, 0.7], dtype=torch.float64), torch.tensor([-2.0, 2.0], dtype=torch.float64), 0.5

def v_marginale(x, t):            # même formule que le bloc précédent (vectorisée en t)
    var = (1 - t) ** 2 + t ** 2 * s ** 2
    g = pi * torch.exp(-0.5 * (x[:, None] - t[:, None] * m) ** 2 / var[:, None]) / torch.sqrt(var[:, None])
    w = g / g.sum(1, keepdim=True)
    vk = m + ((t * s ** 2 - (1 - t)) / var)[:, None] * (x[:, None] - t[:, None] * m)
    return (w * vk).sum(1)

# Petit modèle : v_θ(x, t) = θ · φ(x, t), avec φ = (1, x, t, x t, tanh x)
theta = torch.randn(5, dtype=torch.float64, requires_grad=True)
def v_theta(x, t):
    return torch.stack([torch.ones_like(x), x, t, x * t, torch.tanh(x)], 1) @ theta

n = 1_000_000
x0 = torch.randn(n, dtype=torch.float64)
x1 = torch.where(torch.rand(n, dtype=torch.float64) < pi[0], m[0], m[1]) + s * torch.randn(n, dtype=torch.float64)
t = torch.rand(n, dtype=torch.float64)
xt = (1 - t) * x0 + t * x1

L_cfm = ((v_theta(xt, t) - (x1 - x0)) ** 2).mean()
L_fm = ((v_theta(xt, t) - v_marginale(xt, t)) ** 2).mean()
g_cfm, = torch.autograd.grad(L_cfm, theta)
g_fm, = torch.autograd.grad(L_fm, theta)
print("∇θ L_CFM :", [round(g, 3) for g in g_cfm.tolist()])
print("∇θ L_FM  :", [round(g, 3) for g in g_fm.tolist()])
print(f"L_CFM = {L_cfm.item():.4f}, L_FM = {L_fm.item():.4f}, écart = {L_cfm.item() - L_fm.item():.4f}")
# sortie :
# ∇θ L_CFM : [-1.146, -5.025, -0.972, -3.544, -2.984]
# ∇θ L_FM  : [-1.146, -5.022, -0.972, -3.544, -2.982]
# L_CFM = 7.2183, L_FM = 4.7179, écart = 2.5004
Les deux gradients coïncident à 3 \times 10^{-3} près, l’erreur de Monte-Carlo pour 10^6 tirages, alors que les pertes diffèrent de C \approx 2{,}50. La figure 4.10 et le schéma interactif 4.11 montrent la différence entre les segments conditionnels, qui se croisent, et les trajectoires du flot marginal, qui ne se croisent jamais.
4.4 Rectified flow : redresser les trajectoires
Liu, Gong et Liu (2023) proposent la même perte (avec la même convention X_t = tX_1 + (1 - t)X_0) sous le nom de rectified flow, et insistent sur la géométrie des trajectoires. Les solutions d’une EDO à champ régulier ne peuvent pas se croiser (unicité de Cauchy–Lipschitz) : là où les segments conditionnels se croisent, le flot marginal les « recâble ». Le flot final définit un nouveau couplage (Z_0, Z_1) = (Z_0, \phi_1(Z_0)), déterministe, et l’on peut réentraîner le flow matching sur ces paires : c’est l’opération de reflow.
Théorème 4.12 — Le redressement ne fait pas croître les coûts de transport convexes (Liu, Gong & Liu, 2023) Soit (X_0, X_1) un couplage de p_0 et \mu, X_t = (1 - t)X_0 + tX_1, v le champ marginal associé et Z_t la solution de \dot Z_t = v(Z_t, t), Z_0 = X_0. Alors Z_1 \sim \mu et, pour toute fonction convexe c : \mathbb{R}^D \to \mathbb{R},
\mathbb{E}\big[c(Z_1 - Z_0)\big] \le \mathbb{E}\big[c(X_1 - X_0)\big].
Preuve. La loi de Z_1 est \mu par le théorème 4.4 (sa démonstration vaut pour un couplage quelconque), et plus généralement Z_t et X_t ont même loi pour tout t. On applique deux fois l’inégalité de Jensen, d’abord à la moyenne en temps, puis à l’espérance conditionnelle :
\mathbb{E}\,c(Z_1 - Z_0) = \mathbb{E}\,c\Big(\int_0^1 v(Z_t, t)\,\mathrm{d}t\Big) \le \int_0^1 \mathbb{E}\,c\big(v(Z_t, t)\big)\,\mathrm{d}t = \int_0^1 \mathbb{E}\,c\big(\mathbb{E}[X_1 - X_0 \mid X_t]\big)\,\mathrm{d}t \le \int_0^1 \mathbb{E}\,c(X_1 - X_0)\,\mathrm{d}t.
L’égalité centrale utilise que Z_t et X_t ont même loi et que v(\cdot, t) = \mathbb{E}[X_1 - X_0 \mid X_t = \cdot]. ∎
Si les trajectoires sont des droites, un seul pas d’Euler, \mathbf{x}_1 = \mathbf{x}_0 + v(\mathbf{x}_0, 0), intègre l’EDO exactement : c’est la génération en une étape. Liu et al. (2023) rapportent ainsi, après un redressement (2-rectified flow) suivi d’une distillation, un FID de 4{,}85 en une étape sur CIFAR-10. En dimension 1, le flot marginal est croissant, donc égal au transport monotone F_\mu^{-1}\circ\Phi de la proposition 1.3, et un seul redressement donne des droites (exercice 11). Une autre façon de redresser les chemins sans réentraîner est de coupler \mathbf{x}_0 et \mathbf{x}_1 par transport optimal à l’intérieur de chaque mini-lot (OT-CFM, Tong et al., 2024).
4.5 Interpolants stochastiques et lien avec la diffusion
Albergo et Vanden-Eijnden (2023), puis Albergo, Boffi et Vanden-Eijnden (2025), généralisent le chemin linéaire à un interpolant \mathbf{x}_t = \alpha(t)\,\mathbf{x}_0 + \beta(t)\,\mathbf{x}_1, avec \alpha(0) = \beta(1) = 1 et \alpha(1) = \beta(0) = 0 (on peut aussi ajouter un terme de bruit \gamma(t)\mathbf{z}). Le champ marginal devient b_t(\mathbf{x}) = \mathbb{E}[\dot\alpha(t)\mathbf{x}_0 + \dot\beta(t)\mathbf{x}_1 \mid \mathbf{x}_t = \mathbf{x}], et les théorèmes 4.4 et 4.7 restent vrais mot pour mot. Ce cadre fait apparaître que diffusion et flow matching apprennent le même objet.
Proposition 4.13 — Vitesse et score sont la même information Si \mathbf{x}_0 \sim \mathcal{N}(0, I) est indépendant de \mathbf{x}_1 et si \alpha(t) > 0, \beta(t) > 0, alors le score de p_t s’écrit \nabla\log p_t(\mathbf{x}) = -\mathbb{E}[\mathbf{x}_0 \mid \mathbf{x}_t = \mathbf{x}]/\alpha(t) et
b_t(\mathbf{x}) = \frac{\dot\beta}{\beta}\,\mathbf{x} - \alpha\Big(\dot\alpha - \frac{\alpha\dot\beta}{\beta}\Big)\nabla\log p_t(\mathbf{x}).
Pour le chemin linéaire (\alpha = 1 - t, \beta = t), cela donne
v_t(\mathbf{x}) = \frac{\mathbf{x} + (1 - t)\,\nabla\log p_t(\mathbf{x})}{t}.
Preuve. La formule de Tweedie (proposition 3.7), appliquée à \mathbf{x}_t = \beta\,\mathbf{x}_1 + \alpha\,\mathbf{x}_0 où \mathbf{x}_0 joue le rôle du bruit d’écart-type \alpha, donne \mathbb{E}[\mathbf{x}_0 \mid \mathbf{x}_t] = -\alpha\nabla\log p_t(\mathbf{x}_t). Par linéarité de l’espérance conditionnelle, \mathbf{x} = \alpha\,\mathbb{E}[\mathbf{x}_0 \mid \mathbf{x}] + \beta\,\mathbb{E}[\mathbf{x}_1 \mid \mathbf{x}], d’où \mathbb{E}[\mathbf{x}_1 \mid \mathbf{x}] = (\mathbf{x} - \alpha\,\mathbb{E}[\mathbf{x}_0 \mid \mathbf{x}])/\beta. On reporte dans b_t = \dot\alpha\,\mathbb{E}[\mathbf{x}_0 \mid \mathbf{x}] + \dot\beta\,\mathbb{E}[\mathbf{x}_1 \mid \mathbf{x}] pour obtenir b_t = \frac{\dot\beta}{\beta}\mathbf{x} + \big(\dot\alpha - \frac{\alpha\dot\beta}{\beta}\big)\mathbb{E}[\mathbf{x}_0 \mid \mathbf{x}], puis on remplace l’espérance par le score. Pour le chemin linéaire, \dot\beta/\beta = 1/t et \dot\alpha - \alpha\dot\beta/\beta = -1/t. ∎
Un modèle de diffusion (qui apprend le score) et un modèle de flow matching à source gaussienne (qui apprend la vitesse) sont donc deux paramétrisations d’un même objet ; ce qui les distingue est le chemin (\alpha, \beta), c’est-à-dire le planning de bruit, la pondération de la perte selon t, et le solveur. Le chemin VP de DDPM correspond, en temps du flot t = 1 - s, à \beta(t) = a(1 - t) et \alpha(t) = \sigma(1 - t) avec \alpha^2 + \beta^2 = 1 (proposition 3.2).
Proposition 4.14 — Une famille d’EDS de mêmes lois marginales Pour toute fonction g(t) \ge 0, l’EDS \mathrm{d}\mathbf{x} = \big[v_t(\mathbf{x}) + \tfrac12 g(t)^2\,\nabla\log p_t(\mathbf{x})\big]\mathrm{d}t + g(t)\,\mathrm{d}W_t, partie de \mathcal{N}(0, I), a les mêmes lois marginales p_t que l’EDO \dot{\mathbf{x}} = v_t(\mathbf{x}).
Preuve. Son équation de Fokker–Planck est \partial_t p = -\nabla\cdot\big[(v_t + \tfrac12 g^2\nabla\log p)\,p\big] + \tfrac12 g^2\Delta p = -\nabla\cdot(v_t\,p) - \tfrac12 g^2\nabla\cdot(p\nabla\log p) + \tfrac12 g^2\Delta p = -\nabla\cdot(v_t\,p), car \nabla\cdot(p\nabla\log p) = \Delta p. C’est l’équation de continuité du théorème 4.4, et l’on conclut par unicité. ∎
Avec la proposition 4.13, un modèle de vitesse fournit aussi le score, donc un échantillonneur stochastique : ODE et EDS ne sont que deux façons d’intégrer le même modèle. C’est le cadre « unificateur » d’Albergo, Boffi et Vanden-Eijnden (2025), qui retrouve aussi le pont de Schrödinger lorsque l’interpolant est optimisé.
4.6 En pratique
Le tableau résume les correspondances. Dans tous les cas, l’entraînement est une régression sans simulation et l’échantillonnage une intégration numérique ; le nombre d’évaluations du réseau (NFE) mesure le coût.
| DDPM (ch. 2) | EDS / score (ch. 3) | Flow matching, rectified flow (ch. 4) | |
|---|---|---|---|
| Cible de la régression | bruit \boldsymbol\varepsilon | score -\boldsymbol\varepsilon/\sigma ou débruiteur | vitesse \mathbf{x}_1 - \mathbf{x}_0 |
| Chemin | VP discret, planning \beta_k | VP, VE, EDM | linéaire (1 - t)\mathbf{x}_0 + t\mathbf{x}_1, ou interpolant |
| Source | \mathcal{N}(0, I) (approchée) | \mathcal{N}(0, \sigma_{\max}^2 I) ou \mathcal{N}(0, I) | \mathcal{N}(0, I) exacte, ou toute loi |
| Échantillonneur | ancestral (K NFE), DDIM | EDS inverse, ODE (Heun) | ODE (Euler, Heun), EDS (prop. 4.14) |
| Point fort | simplicité, robustesse | cadre unifié, vraisemblance par l’ODE | chemins droits, peu de pas, source quelconque |
Trois choix pratiques comptent. La loi de t : uniforme par défaut, elle peut être concentrée là où la régression est la plus difficile. Le solveur : Heun est d’ordre 2 (erreur globale en O(h^2) pour deux évaluations par pas), Euler d’ordre 1. Le couplage : indépendant par défaut, il peut être rendu plus « droit » par transport optimal en mini-lot (Tong et al., 2024) ou par reflow.
Ce qu’il faut retenir — chapitre 4
- On fixe un chemin \mathbf{x}_t = (1 - t)\mathbf{x}_0 + t\mathbf{x}_1 ; le champ marginal v_t(\mathbf{x}) = \mathbb{E}[\mathbf{x}_1 - \mathbf{x}_0 \mid \mathbf{x}_t = \mathbf{x}] vérifie l’équation de continuité et transporte exactement le bruit sur les données.
- Théorème des gradients : L_{\mathrm{CFM}} = L_{\mathrm{FM}} + C ; régresser sur la vitesse conditionnelle \mathbf{x}_1 - \mathbf{x}_0 suffit, et la perte tend vers C > 0.
- Les trajectoires du flot marginal ne se croisent pas ; le redressement (reflow) ne fait croître aucun coût de transport convexe et rend les trajectoires plus droites.
- Avec une source gaussienne, vitesse et score se déduisent l’un de l’autre : v_t = (\mathbf{x} + (1 - t)\nabla\log p_t)/t ; diffusion et flow matching diffèrent par le chemin, la pondération et le solveur.
5. Conditionnement par des paramètres et guidage
Le stage ne demande pas un modèle de la loi des champs MHD, mais une famille de lois \mu_{\boldsymbol\lambda} indexée par des paramètres physiques : nombres de Reynolds cinétique Re et magnétique Rm, propriétés des matériaux. Ce chapitre montre comment conditionner un modèle génératif par \boldsymbol\lambda, puis comment orienter l’échantillonnage vers des observations ou des contraintes sans réentraîner, et pourquoi ces guidages sont approchés.
5.1 Génération conditionnelle
Les données d’entraînement sont des paires (\boldsymbol\lambda^{(j)}, \mathbf{x}^{(j, i)}) : pour chaque valeur \boldsymbol\lambda^{(j)} simulée, des instantanés \mathbf{x}^{(j, i)} d’un état statistiquement stationnaire, donc des échantillons de \mu_{\boldsymbol\lambda^{(j)}}. On note \nu la loi des paramètres dans le jeu d’entraînement.
Définition 5.1 — Flow matching conditionnel Le champ v_\theta(\mathbf{x}, t, \boldsymbol\lambda) reçoit le paramètre en entrée et minimise
L(\theta) = \mathbb{E}_{\boldsymbol\lambda \sim \nu,\; \mathbf{x}_1 \sim \mu_{\boldsymbol\lambda},\; \mathbf{x}_0 \sim \mathcal{N}(0, I),\; t \sim \mathcal{U}[0, 1]}\big\|v_\theta(\mathbf{x}_t, t, \boldsymbol\lambda) - (\mathbf{x}_1 - \mathbf{x}_0)\big\|^2.
Pour générer à \boldsymbol\lambda donné, on intègre \dot{\mathbf{x}} = v_\theta(\mathbf{x}, t, \boldsymbol\lambda) de t = 0 à t = 1.
Proposition 5.2 — Le minimiseur est le champ marginal conditionnel Sur toutes les fonctions de carré intégrable, L est minimisée par v^\star(\mathbf{x}, t, \boldsymbol\lambda) = \mathbb{E}[\mathbf{x}_1 - \mathbf{x}_0 \mid \mathbf{x}_t = \mathbf{x}, \boldsymbol\lambda], pour \nu-presque tout \boldsymbol\lambda ; ce champ transporte \mathcal{N}(0, I) sur \mu_{\boldsymbol\lambda}.
Preuve. On conditionne par \boldsymbol\lambda : L(\theta) = \mathbb{E}_{\boldsymbol\lambda}\big[L_{\mathrm{CFM}}(\theta; \boldsymbol\lambda)\big], où L_{\mathrm{CFM}}(\theta; \boldsymbol\lambda) est la perte du théorème 4.7 pour la cible \mu_{\boldsymbol\lambda}. Ce théorème donne L_{\mathrm{CFM}}(\theta; \boldsymbol\lambda) = L_{\mathrm{FM}}(\theta; \boldsymbol\lambda) + C(\boldsymbol\lambda), minimisée pour chaque \boldsymbol\lambda par le champ marginal de \mu_{\boldsymbol\lambda} ; le théorème 4.4 conclut. ∎
Remarque 5.3 — Ce que le théorème ne dit pas : l’interpolation en \boldsymbol\lambda La proposition 5.2 ne concerne que les valeurs de \boldsymbol\lambda présentes dans les données. En pratique, on ne simule qu’une poignée de valeurs de (Re, Rm), et l’on espère que le réseau interpole entre elles. Cela repose sur la régularité de \boldsymbol\lambda \mapsto \mu_{\boldsymbol\lambda} et sur le biais inductif du réseau, pas sur un théorème. Or les systèmes du stage ont des bifurcations : au seuil de l’effet dynamo Rm_c, la loi stationnaire du champ magnétique change de nature (champ nul en dessous, champ auto-entretenu au-dessus ; voir les modules p3 et p4). Un modèle conditionnel doit donc être testé à des valeurs de \boldsymbol\lambda absentes de l’entraînement, à l’intérieur de la plage et au-delà ; Kohl, Chen et Thuerey (2026) évaluent ainsi leurs modèles de diffusion d’écoulements à des nombres de Reynolds hors de la plage d’entraînement.
Le paramètre peut entrer dans le réseau par simple concaténation (comme dans le code de la section 5.6), par un plongement suivi d’une modulation des couches (FiLM, ou AdaLN-Zero dans les transformeurs de diffusion qu’utilise FunDiff), et il vaut mieux le normaliser, par exemple en passant à \log Re.
5.2 Guidage par classifieur
Supposons qu’on dispose d’un modèle non conditionnel et qu’on veuille générer sachant une étiquette c (par exemple « polarité du dipôle positive »). La formule de Bayes, appliquée à chaque instant, donne
\nabla_{\mathbf{x}}\log p_t(\mathbf{x} \mid c) = \nabla_{\mathbf{x}}\log p_t(\mathbf{x}) + \nabla_{\mathbf{x}}\log p_t(c \mid \mathbf{x}).
Dhariwal et Nichol (2021) entraînent un classifieur p_t(c \mid \mathbf{x}_t) sur des données bruitées et ajoutent son gradient au score, multiplié par un poids w. Cela exige d’entraîner un classifieur supplémentaire, qui reçoit le niveau de bruit en entrée et doit reconnaître la classe sur des données bruitées à tous les niveaux : c’est ce coût qui motive les deux méthodes suivantes.
5.3 Guidage sans classifieur
Définition 5.4 — Guidage sans classifieur (Ho & Salimans, 2022) On entraîne un seul réseau, conditionnel et non conditionnel à la fois : à chaque exemple, la condition c est remplacée par un jeton vide \varnothing avec une probabilité p_{\mathrm{uncond}}. À l’échantillonnage, on combine les deux prédictions avec un poids w \ge 0 :
\tilde{\boldsymbol\varepsilon}(\mathbf{z}, c) = (1 + w)\,\boldsymbol\varepsilon_\theta(\mathbf{z}, c) - w\,\boldsymbol\varepsilon_\theta(\mathbf{z}, \varnothing).
En termes de scores (\boldsymbol\varepsilon = -\sigma s), cette combinaison vaut s(\mathbf{x} \mid c) + w\,\big[s(\mathbf{x} \mid c) - s(\mathbf{x})\big] = s(\mathbf{x} \mid c) + w\,\nabla\log p_t(c \mid \mathbf{x}) : c’est le guidage par un classifieur implicite, sans classifieur à entraîner. Ho et Salimans testent p_{\mathrm{uncond}} \in \{0{,}1 ; 0{,}2 ; 0{,}5\} : les deux premières valeurs sont équivalentes, la troisième est moins bonne. Sur ImageNet 64 \times 64, le FID passe de 1{,}8 à w = 0 à 1{,}55 à w = 0{,}1, mais vaut 26{,}22 à w = 4 (avec un score Inception de 260{,}2) : un fort guidage améliore la netteté et la fidélité à la classe au prix de la diversité.
Proposition 5.5 — Guidage sans classifieur pour un modèle de vitesse Pour le chemin linéaire à source gaussienne, la combinaison \tilde v = (1 + w)\,v_\theta(\mathbf{x}, t, \boldsymbol\lambda) - w\,v_\theta(\mathbf{x}, t, \varnothing) est la vitesse associée, par la proposition 4.13, au score guidé (1 + w)\,s(\mathbf{x} \mid \boldsymbol\lambda) - w\,s(\mathbf{x}).
Preuve. À (\mathbf{x}, t) fixés, la proposition 4.13 donne v = \mathbf{x}/t + \frac{1 - t}{t}\,s, application affine du score. Une combinaison de coefficients (1 + w) et -w, de somme 1, commute avec une application affine : (1 + w)\big(\frac{\mathbf{x}}{t} + \frac{1-t}{t}s_c\big) - w\big(\frac{\mathbf{x}}{t} + \frac{1-t}{t}s_\varnothing\big) = \frac{\mathbf{x}}{t} + \frac{1-t}{t}\big((1 + w)s_c - w\,s_\varnothing\big). ∎
Le score guidé est, à chaque instant, celui de la loi inclinée p_t(\mathbf{x} \mid c)\,p_t(c \mid \mathbf{x})^w (normalisée). Mais la famille de ces lois inclinées n’est pas le chemin de probabilité d’un processus de bruitage : l’EDO guidée ne produit pas exactement p_1(\mathbf{x} \mid c)\,p(c \mid \mathbf{x})^w. Pour la physique, la conséquence est nette : si l’on veut la loi \mu_{\boldsymbol\lambda} elle-même (spectres, statistiques d’un état stationnaire), le guidage doit être nul ou très faible, car il déforme la loi. L’exercice 14 le mesure.
5.4 Guidage par l’estimation débruitée : DPS et universal guidance
On veut maintenant générer des champs compatibles avec une observation \mathbf{y} = \mathcal{A}(\mathbf{x}_1) + \boldsymbol\eta (mesures éparses, champ grossier) ou une contrainte R(\mathbf{x}_1) \approx 0 (résidu d’une équation), avec un modèle déjà entraîné. Par Bayes, il faudrait ajouter au score \nabla_{\mathbf{x}}\log p_t(\mathbf{y} \mid \mathbf{x}_t), avec
p_t(\mathbf{y} \mid \mathbf{x}_t) = \int p(\mathbf{y} \mid \mathbf{x}_1)\,p(\mathbf{x}_1 \mid \mathbf{x}_t)\,\mathrm{d}\mathbf{x}_1,
intégrale inaccessible puisque p(\mathbf{x}_1 \mid \mathbf{x}_t) est la loi a posteriori complète.
Proposition 5.6 — Estimée débruitée d’un modèle de vitesse Pour le chemin linéaire, \hat{\mathbf{x}}_1(\mathbf{x}, t) := \mathbb{E}[\mathbf{x}_1 \mid \mathbf{x}_t = \mathbf{x}] = \mathbf{x} + (1 - t)\,v_t(\mathbf{x}).
Preuve. Par linéarité de l’espérance conditionnelle, \mathbf{x} = (1 - t)\,\mathbb{E}[\mathbf{x}_0 \mid \mathbf{x}] + t\,\mathbb{E}[\mathbf{x}_1 \mid \mathbf{x}] et v_t(\mathbf{x}) = \mathbb{E}[\mathbf{x}_1 \mid \mathbf{x}] - \mathbb{E}[\mathbf{x}_0 \mid \mathbf{x}]. Alors \mathbf{x} + (1 - t)v_t(\mathbf{x}) = (1 - t)\mathbb{E}[\mathbf{x}_0 \mid \mathbf{x}] + t\,\mathbb{E}[\mathbf{x}_1 \mid \mathbf{x}] + (1 - t)\mathbb{E}[\mathbf{x}_1 \mid \mathbf{x}] - (1 - t)\mathbb{E}[\mathbf{x}_0 \mid \mathbf{x}] = \mathbb{E}[\mathbf{x}_1 \mid \mathbf{x}]. ∎
C’est l’analogue de la formule de Tweedie : l’estimée débruitée s’obtient gratuitement à partir de la vitesse prédite, en une évaluation du réseau. L’expérience E2 du dépôt l’utilise pour pénaliser la divergence de \hat{\mathbf{x}}_1 = \mathbf{x}_t + (1 - t)\,v_\theta.
Définition 5.7 — Diffusion Posterior Sampling (Chung et al., 2023) DPS remplace la vraisemblance inaccessible par p_t(\mathbf{y} \mid \mathbf{x}_t) \approx p(\mathbf{y} \mid \hat{\mathbf{x}}_1(\mathbf{x}_t)) et ajoute, à chaque pas de l’échantillonneur, un pas de gradient à travers le réseau. Dans la convention de la diffusion (estimée \hat{\mathbf{x}}_0 par Tweedie), la mise à jour s’écrit \mathbf{x}_{i-1} \leftarrow \mathbf{x}'_{i-1} - \zeta_i\,\nabla_{\mathbf{x}_i}\|\mathbf{y} - \mathcal{A}(\hat{\mathbf{x}}_0(\mathbf{x}_i))\|^2, avec \zeta_i = \zeta'/\|\mathbf{y} - \mathcal{A}(\hat{\mathbf{x}}_0)\|, où \mathbf{x}'_{i-1} est le pas non guidé.
Bansal et al. (2024) généralisent l’idée (universal guidance) à une fonction de perte \ell(c, f(\hat{\mathbf{x}}_0)) définie par n’importe quel réseau f entraîné sur des données propres (segmentation, reconnaissance, ou en physique un résidu d’équation). Leur forward guidance ajoute s(t)\,\nabla\ell(c, f(\hat{\mathbf{x}}_0)) au bruit prédit ; leur backward guidance cherche une correction \Delta de l’estimée débruitée par quelques pas de descente sur \ell(c, f(\hat{\mathbf{x}}_0 + \Delta)) ; enfin la self-recurrence re-bruite et répète chaque pas k fois. Les hyperparamètres (par exemple s(t) = 10\sqrt{1 - \alpha_t} et k = 8 pour un guidage par CLIP) doivent être réglés pour chaque réseau de guidage. Toutes ces méthodes imposent une contrainte douce, à l’échantillonnage, sans réentraînement, et elles reposent toutes sur une approximation : remplacer une espérance d’une fonction par la fonction de l’espérance.
5.5 L’écart de Jensen
Définition 5.8 — Écart de Jensen Pour une fonction R : \mathbb{R}^D \to \mathbb{R}^m (contrainte, observable), l’écart de Jensen au point (\mathbf{x}, t) est
\mathcal{J}_R(\mathbf{x}, t) = \mathbb{E}\big[R(\mathbf{x}_1) \mid \mathbf{x}_t = \mathbf{x}\big] - R\big(\mathbb{E}[\mathbf{x}_1 \mid \mathbf{x}_t = \mathbf{x}]\big).
Proposition 5.9 — Propriétés de l’écart de Jensen (i) Si R est affine, \mathcal{J}_R = 0. (ii) Si R est scalaire et convexe, \mathcal{J}_R \ge 0. (iii) Pour R(\mathbf{x}) = \|\mathbf{x}\|^2, \mathcal{J}_R(\mathbf{x}, t) = \mathrm{tr}\,\mathrm{Cov}(\mathbf{x}_1 \mid \mathbf{x}_t = \mathbf{x}). (iv) Si les données vérifient toutes une contrainte linéaire A\mathbf{x}_1 = 0, alors l’estimée débruitée exacte la vérifie aussi : A\,\hat{\mathbf{x}}_1(\mathbf{x}, t) = 0 pour tous \mathbf{x} et t.
Preuve.
- L’espérance conditionnelle est linéaire. (ii) C’est l’inégalité de Jensen conditionnelle. (iii) \mathbb{E}[\|\mathbf{x}_1\|^2 \mid \mathbf{x}_t] - \|\mathbb{E}[\mathbf{x}_1 \mid \mathbf{x}_t]\|^2 est la trace de la covariance conditionnelle (formule de König–Huygens composante par composante). (iv) Par (i), A\,\hat{\mathbf{x}}_1 = \mathbb{E}[A\mathbf{x}_1 \mid \mathbf{x}_t] = 0. ∎
À retenir — contraintes linéaires et quadratiques ne se traitent pas pareil La divergence \nabla\cdot\mathbf{B} est linéaire en le champ : elle commute avec l’espérance conditionnelle, il n’y a pas d’écart de Jensen, et l’estimée débruitée d’un modèle exact entraîné sur des champs solénoïdaux est solénoïdale. L’énergie \tfrac12\langle|\mathbf{B}|^2\rangle est quadratique : l’estimée débruitée a moins d’énergie que les vrais champs, d’un montant égal à la variance a posteriori. Pénaliser l’énergie de \hat{\mathbf{x}}_1 pour la caler sur la valeur physique est donc biaisé aux petits t. C’est pourquoi l’expérience E2 traite la divergence échantillon par échantillon et le bilan d’énergie en loi. Bastek, Sun et Kochmann (2025) rencontrent la même difficulté avec un résidu d’équation évalué sur l’estimée débruitée et proposent de l’évaluer sur un échantillon obtenu par quelques pas de DDIM, au prix d’un entraînement plus long.
Attention : (iv) concerne l’estimée débruitée, pas la vitesse. Comme v_t(\mathbf{x}) = \mathbb{E}[\mathbf{x}_1 \mid \mathbf{x}] - \mathbb{E}[\mathbf{x}_0 \mid \mathbf{x}] et que le bruit gaussien \mathbf{x}_0 n’est pas solénoïdal, Av_t \ne 0 en général, et les états intermédiaires \mathbf{x}_t ne vérifient pas la contrainte. Projeter aussi le bruit sur \ker A (« flot projeté » de E2) rend tout le chemin solénoïdal ; le module p8 compare ces options.
Exemple 5.10 — L’écart de Jensen en fonction du temps Pour la cible unidimensionnelle 0{,}3\,\mathcal{N}(-2, 0{,}5^2) + 0{,}7\,\mathcal{N}(2, 0{,}5^2), la loi a posteriori de x_1 sachant x_t est un mélange de gaussiennes explicite (même calcul que la proposition 4.8). Le bloc suivant calcule l’écart de Jensen moyen pour R(x) = x^2, c’est-à-dire \mathbb{E}[\mathrm{Var}(x_1 \mid x_t)], et l’« énergie » \mathbb{E}[\hat x_1^2] de l’estimée débruitée.
import numpy as np

# Cible 1D : 0,3 N(-2, 0,5²) + 0,7 N(2, 0,5²) ; chemin x_t = (1-t) x0 + t x1, x0 ~ N(0, 1)
pi, m, s = np.array([0.3, 0.7]), np.array([-2.0, 2.0]), 0.5

def posterieur(x, t):
    """Moments de x1 sachant x_t = x : E[x1 | x_t], E[x1² | x_t] (mélange de gaussiennes a posteriori)."""
    var = (1 - t) ** 2 + t ** 2 * s ** 2
    logw = np.log(pi) - 0.5 * (x[:, None] - t * m) ** 2 / var
    w = np.exp(logw - logw.max(1, keepdims=True)); w /= w.sum(1, keepdims=True)
    moy_k = m + t * s ** 2 / var * (x[:, None] - t * m)
    var_k = s ** 2 * (1 - t) ** 2 / var
    return (w * moy_k).sum(1), (w * (var_k + moy_k ** 2)).sum(1)

rng = np.random.default_rng(0)
n = 200_000
x0 = rng.standard_normal(n)
x1 = np.where(rng.random(n) < pi[0], m[0], m[1]) + s * rng.standard_normal(n)
print(f"E[x1²] = {np.mean(x1 ** 2):.4f}")
print("   t    écart de Jensen moyen E[Var(x1|x_t)]    « énergie » de l'estimée E[x̂1²]")
for t in [0.0, 0.25, 0.5, 0.75, 0.9, 0.99]:
    xt = (1 - t) * x0 + t * x1
    e1, e2 = posterieur(xt, t)
    ecart = np.mean(e2 - e1 ** 2)               # E[R(x1)|x_t] - R(x̂1) = Var(x1 | x_t) pour R(x) = x²
    print(f"{t:5.2f}   {ecart:12.4f}                            {np.mean(e1 ** 2):8.4f}")
# sortie :
# E[x1²] = 4.2516
#    t    écart de Jensen moyen E[Var(x1|x_t)]    « énergie » de l'estimée E[x̂1²]
#  0.00         3.6100                              0.6400
#  0.25         2.4979                              1.7526
#  0.50         0.4539                              3.7969
#  0.75         0.0774                              4.1745
#  0.90         0.0118                              4.2401
#  0.99         0.0001                              4.2515
À t = 0, l’estimée débruitée est la moyenne des données (0{,}8, d’énergie 0{,}64) et l’écart vaut toute la variance (3{,}61). L’écart s’effondre entre t = 0{,}25 et t = 0{,}5, quand le mode est « choisi », puis décroît comme la variance intra-mode. La somme des deux colonnes reste égale à \mathbb{E}[x_1^2] = 4{,}25 : c’est la décomposition de la variance totale.
5.6 Travail pratique : flow matching conditionnel en dimension 2
On assemble tout : un jeu de données paramétrique, un champ de vitesse conditionnel en PyTorch, l’échantillonnage par Heun et l’évaluation par la distance d’énergie (chapitre 7). La loi \mu_\lambda est un mélange de quatre gaussiennes d’écart-type 0{,}15, placées sur un cercle de rayon 1 + \lambda et tournées d’un angle \lambda\pi/4. On n’entraîne qu’avec cinq valeurs, \lambda \in \{0 ; 0{,}25 ; 0{,}5 ; 0{,}75 ; 1\}, comme si l’on disposait de cinq simulations, et l’on teste aussi en \lambda = 0{,}375 et \lambda = 0{,}625, valeurs jamais vues.
import math, time
import torch
import torch.nn as nn

torch.manual_seed(0)
torch.set_num_threads(1)

# --- Données : mélange de 4 gaussiennes dont la position dépend du paramètre λ ∈ [0, 1] ---
def echantillons(lam, n):
    """n points de μ_λ : 4 modes sur un cercle de rayon 1 + λ, tourné de λπ/4, écart-type 0,15."""
    lam = torch.as_tensor(lam, dtype=torch.float32).expand(n)   # λ scalaire ou vecteur de taille n
    k = torch.randint(0, 4, (n,))
    ang = k * math.pi / 2 + lam * math.pi / 4
    centre = (1.0 + lam)[:, None] * torch.stack([torch.cos(ang), torch.sin(ang)], 1)
    return centre + 0.15 * torch.randn(n, 2)

LAM_TRAIN = torch.tensor([0.0, 0.25, 0.5, 0.75, 1.0])   # 5 « simulations » disponibles

# --- Champ de vitesse v_θ(x, t, λ) : un perceptron multicouche ---
class Champ(nn.Module):
    def __init__(self, largeur=128):
        super().__init__()
        self.net = nn.Sequential(nn.Linear(4, largeur), nn.SiLU(), nn.Linear(largeur, largeur), nn.SiLU(),
                                 nn.Linear(largeur, largeur), nn.SiLU(), nn.Linear(largeur, 2))
    def forward(self, x, t, lam):
        return self.net(torch.cat([x, t[:, None], lam[:, None]], 1))

v = Champ()
opt = torch.optim.Adam(v.parameters(), lr=2e-3)
n_iter, B = 3000, 256
sched = torch.optim.lr_scheduler.CosineAnnealingLR(opt, n_iter)
t0 = time.time()
for it in range(n_iter):
    lam = LAM_TRAIN[torch.randint(0, 5, (B,))]
    x1 = echantillons(lam, B)                    # données, convention t = 1
    x0 = torch.randn(B, 2)                       # bruit, convention t = 0
    t = torch.rand(B)
    xt = (1 - t[:, None]) * x0 + t[:, None] * x1  # chemin linéaire
    perte = ((v(xt, t, lam) - (x1 - x0)) ** 2).sum(1).mean()   # perte conditionnelle L_CFM
    opt.zero_grad(); perte.backward(); opt.step(); sched.step()
print(f"entraînement : {time.time() - t0:.1f} s, perte finale {perte.item():.3f}")

# --- Échantillonnage : schéma de Heun (ordre 2) de t = 0 à t = 1 ---
@torch.no_grad()
def echantillonner(v, lam, n, pas=50, heun=True):
    x = torch.randn(n, 2)                      # x0 ~ N(0, I)
    L = torch.full((n,), float(lam))
    h = 1.0 / pas
    for i in range(pas):
        t = torch.full((n,), i * h)
        d0 = v(x, t, L)
        if not heun:                           # Euler : 1 évaluation par pas
            x = x + h * d0
            continue
        d1 = v(x + h * d0, t + h, L)           # Heun : prédiction d'Euler puis trapèzes
        x = x + 0.5 * h * (d0 + d1)
    return x

# --- Distance d'énergie (estimateur sans biais, U-statistique) ---
def distance_energie(X, Y):
    n, m = len(X), len(Y)
    dxy = torch.cdist(X, Y).mean()
    dxx = torch.cdist(X, X).sum() / (n * (n - 1))
    dyy = torch.cdist(Y, Y).sum() / (m * (m - 1))
    return (2 * dxy - dxx - dyy).item()

n = 2000
print("λ       Heun 50 pas   Euler 10 pas   plancher (réf./réf.)   gaussienne ajustée")
for lam in [0.25, 0.5, 0.375, 0.625]:      # 0,375 et 0,625 : valeurs absentes de l'entraînement
    ref, ref2 = echantillons(lam, n), echantillons(lam, n)
    g_heun = echantillonner(v, lam, n, pas=50)                 # 99 évaluations du réseau
    g_euler = echantillonner(v, lam, n, pas=10, heun=False)    # 10 évaluations
    gauss = ref.mean(0) + torch.randn(n, 2) @ torch.linalg.cholesky(torch.cov(ref.T)).T
    print(f"{lam:5.3f}   {distance_energie(g_heun, ref):9.4f}   {distance_energie(g_euler, ref):11.4f}"
          f"   {distance_energie(ref2, ref):+15.4f}   {distance_energie(gauss, ref):17.4f}")
# sortie :
# entraînement : 13.4 s, perte finale 2.628
# λ       Heun 50 pas   Euler 10 pas   plancher (réf./réf.)   gaussienne ajustée
# 0.250      0.0006        0.0041           -0.0007              0.0736
# 0.500      0.0010        0.0039           -0.0007              0.0990
# 0.375      0.0002        0.0043           +0.0009              0.0841
# 0.625     -0.0002        0.0033           -0.0017              0.1078
Trois constats. D’abord, avec Heun et 50 pas (99 évaluations du réseau), la distance d’énergie entre échantillons générés et données est au niveau du plancher de bruit, c’est-à-dire de la distance entre deux jeux de données indépendants de même taille (\pm 0{,}002) ; elle est environ deux ordres de grandeur plus petite que celle d’une gaussienne de même moyenne et de même covariance, qui rate la structure en quatre modes. Ensuite, la qualité est la même aux valeurs \lambda = 0{,}375 et 0{,}625 absentes de l’entraînement : sur cet exemple très régulier en \lambda, le réseau interpole correctement. Enfin, Euler avec 10 pas (10 évaluations) laisse une distance d’environ 0{,}004, nettement au-dessus du plancher, mais encore vingt fois plus petite que celle de la référence gaussienne : l’erreur d’intégration se voit, sans masquer la structure. La perte finale, 2{,}63, ne tend pas vers 0 : c’est la constante C du théorème 4.7 (plus le bruit du mini-lot).
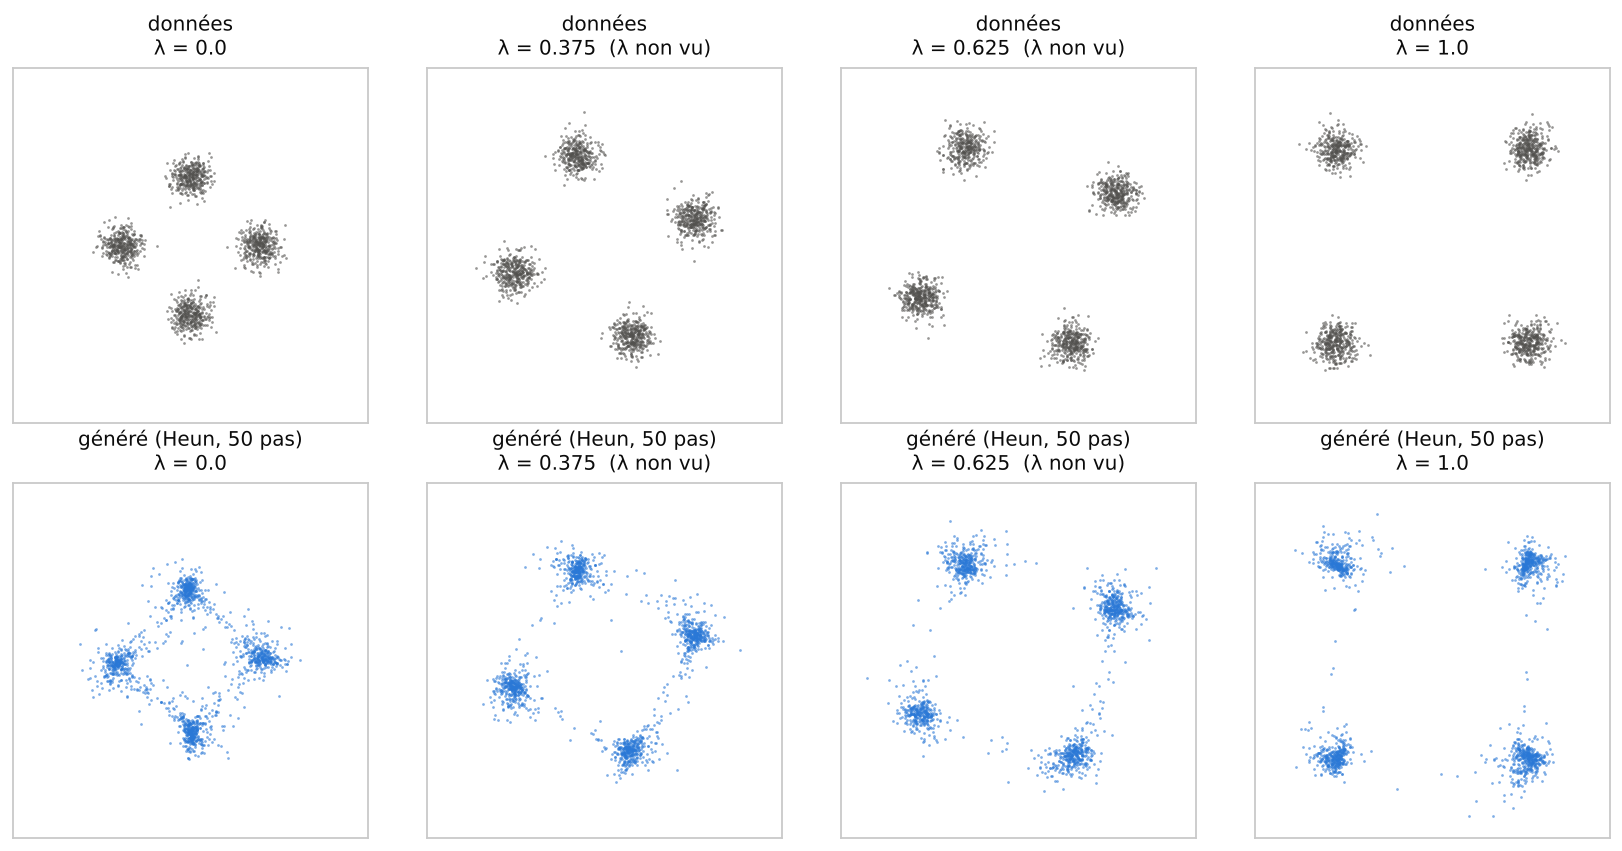
Les filaments visibles sur la figure 5.11 ne sont pas un défaut d’entraînement que l’on pourrait éliminer complètement : le flot d’une EDO est un difféomorphisme de \mathbb{R}^D, et l’image de la gaussienne par un difféomorphisme a une densité strictement positive partout. Un modèle par flot ne peut donc jamais produire des modes rigoureusement séparés ; il peut seulement rendre très faible la masse entre eux. Pour des champs physiques, cela signifie que des états « intermédiaires » non physiques peuvent apparaître avec une faible probabilité, ce que les métriques du chapitre 7 doivent détecter.
Ce qu’il faut retenir — chapitre 5
- Le flow matching conditionnel régresse v_\theta(\mathbf{x}_t, t, \boldsymbol\lambda) sur \mathbf{x}_1 - \mathbf{x}_0 ; il apprend le champ marginal de chaque \mu_{\boldsymbol\lambda} vue, mais l’interpolation en \boldsymbol\lambda n’est pas garantie, surtout près d’une bifurcation.
- Guidage sans classifieur : \tilde v = (1 + w)\,v(\cdot, \boldsymbol\lambda) - w\,v(\cdot, \varnothing) ; il accentue la condition mais déforme la loi, ce qui est indésirable quand on veut les statistiques exactes.
- DPS et universal guidance guident par l’estimée débruitée \hat{\mathbf{x}}_1 = \mathbf{x}_t + (1 - t)v_t, en remplaçant \mathbb{E}[R(\mathbf{x}_1) \mid \mathbf{x}_t] par R(\hat{\mathbf{x}}_1).
- L’écart de Jensen est nul pour une contrainte linéaire (divergence), positif pour une contrainte convexe (énergie, égal à la variance a posteriori), et tend vers 0 quand t \to 1.
6. Génération latente et en espace de fonctions
Un champ MHD tridimensionnel discrétisé sur 64^3 points, avec ses six composantes (\mathbf{u}, \mathbf{B}), est un vecteur de dimension D \approx 1{,}6 \times 10^6. Générer directement dans cet espace coûte cher, impose une résolution fixe, et les contraintes physiques doivent y être respectées point par point. Ce chapitre présente deux réponses : comprimer les champs dans un espace latent de petite dimension, ou formuler la génération en espace de fonctions, indépendamment de la grille. FunDiff, la référence principale de l’offre de stage, combine les deux.
6.1 Diffusion latente
Définition 6.1 — Modèle génératif latent Un autoencodeur (E, \mathcal{D}) est entraîné à reconstruire les données : \mathcal{D}(E(\mathbf{x})) \approx \mathbf{x}, avec un latent \mathbf{z} = E(\mathbf{x}) \in \mathbb{R}^d, d \ll D. On entraîne ensuite un modèle de diffusion ou de flow matching sur la loi des latents E_\#\mu, puis l’on génère \mathbf{x} = \mathcal{D}(\mathbf{z}) à partir d’un latent généré (Rombach et al., 2022).
Le gain est double : le modèle génératif travaille en dimension d, et l’autoencodeur absorbe les détails de haute fréquence. Le prix est que la fidélité est bornée par l’erreur de reconstruction de \mathcal{D}, et que les latents générés peuvent sortir de la région où le décodeur a été entraîné. Pour la physique, une question se pose : où vont les contraintes ? La réponse la plus robuste est dans le décodeur.
Proposition 6.2 — Contrainte linéaire imposée par le décodeur Si le décodeur produit une fonction de courant \psi = \mathcal{D}(\mathbf{z}) et que le champ est reconstruit par \mathbf{u} = \nabla^\perp\psi = (\partial_y\psi, -\partial_x\psi), alors \nabla\cdot\mathbf{u} = 0 pour tout latent \mathbf{z}, quelles que soient les erreurs du modèle génératif latent. En dimension 3, le même rôle est joué par un potentiel vecteur, \mathbf{B} = \nabla\times\mathbf{A}, avec une jauge à choisir.
Preuve. \nabla\cdot\nabla^\perp\psi = \partial_x\partial_y\psi - \partial_y\partial_x\psi = 0 par le théorème de Schwarz, dès que \psi est de classe C^2 ; de même \nabla\cdot(\nabla\times\mathbf{A}) = 0 (module p1). La contrainte ne dépend pas de \mathbf{z}. ∎
C’est la variante « potentiels » de l’expérience E2 du dépôt, et le choix de FunDiff pour l’écoulement de Kolmogorov.
6.2 Le bruit en espace de fonctions
Un champ physique est une fonction \mathbf{u} : \Omega \to \mathbb{R}^d, dont la grille n’est qu’une représentation. On voudrait un modèle génératif défini sur les fonctions elles-mêmes, utilisable à toute résolution. Un obstacle apparaît immédiatement : le bruit blanc gaussien, source naturelle en dimension finie, n’est pas une fonction de carré intégrable.
Proposition 6.3 — Bruit gaussien en dimension infinie Soit (e_k)_{k \ge 1} une base orthonormée de L^2(\Omega), (\xi_k) des variables gaussiennes centrées réduites indépendantes et \kappa_k \ge 0 des variances (on les note \kappa_k pour ne pas les confondre avec les paramètres physiques \boldsymbol\lambda). Le champ aléatoire \mathbf{x}_0 = \sum_k \sqrt{\kappa_k}\,\xi_k\,e_k vérifie
\mathbb{E}\,\|\mathbf{x}_0\|_{L^2}^2 = \sum_k \kappa_k.
La série converge en moyenne quadratique, c’est-à-dire dans L^2\big(\mathbb{P}; L^2(\Omega)\big), si et seulement si la covariance est à trace finie, \sum_k\kappa_k < \infty. Le bruit blanc (\kappa_k = 1 pour tout k) n’en fait pas partie : sur une grille de N points, sa norme L^2 discrète croît comme \sqrt{N}.
Preuve. Pour la somme partielle S_n = \sum_{k \le n}\sqrt{\kappa_k}\,\xi_k\,e_k, l’orthonormalité donne \|S_n\|^2 = \sum_{k \le n}\kappa_k\,\xi_k^2, d’espérance \sum_{k \le n}\kappa_k. De même \mathbb{E}\|S_n - S_m\|^2 = \sum_{m < k \le n}\kappa_k : la suite (S_n) est de Cauchy dans L^2\big(\mathbb{P}; L^2(\Omega)\big) si et seulement si \sum\kappa_k < \infty. Sur une grille de N points, seuls environ N modes sont représentables, d’où \mathbb{E}\|\mathbf{x}_0\|^2 \approx N pour le bruit blanc. ∎
Un modèle génératif en espace de fonctions part donc d’une mesure gaussienne de covariance à trace finie, par exemple un champ gaussien de spectre \kappa_k \propto |k|^{-\alpha}, et non du bruit blanc.
Exemple 6.4 — Un même tirage sur des grilles de plus en plus fines Sur [0, 1) périodique, on tire une fois pour toutes les coefficients \xi_k de 4096 modes de Fourier, puis l’on évalue le champ \mathbf{x}_0 = \sum_k \sqrt{\kappa_k}\,\xi_k\,e^{2i\pi ks} sur des grilles de N = 32 à 2048 points, en ne gardant que les modes que chaque grille peut représenter. On compare le bruit blanc (\kappa_k = 1) à un champ gaussien de spectre \kappa_k = k^{-2} : si le tirage définit une fonction, sa norme doit se stabiliser et ses valeurs aux mêmes points doivent converger quand la grille se raffine.
import numpy as np

# Un même tirage aléatoire, évalué sur des grilles de plus en plus fines de [0, 1) périodique :
# x0(s) = Σ_{1 ≤ |k| ≤ 4096} sqrt(κ_k) ξ_k e^{2iπks}, ξ_k gaussiens complexes (champ réel).
rng = np.random.default_rng(0)
kmax = 4096
k = np.arange(1, kmax + 1)
xi = (rng.standard_normal(kmax) + 1j * rng.standard_normal(kmax)) / np.sqrt(2)

def champ(kap_k, N):
    """Évalue le champ sur N points en ne gardant que les modes représentables (|k| < N/2)."""
    c = np.zeros(N, dtype=complex)
    kk = k[k < N // 2]
    c[kk] = np.sqrt(kap_k[: len(kk)]) * xi[: len(kk)]
    return 2 * np.real(np.fft.ifft(c) * N)          # somme des modes k et -k

spectres = {"bruit blanc (κ_k = 1)": np.ones(kmax), "champ gaussien (κ_k = k^-2)": k ** -2.0}
for nom, kap_k in spectres.items():
    print(nom)
    for N in [32, 128, 512, 2048]:
        u = champ(kap_k, N)
        u_fin = champ(kap_k, 2 * N)[::2]              # même tirage, grille deux fois plus fine
        print(f"  N = {N:5d} : ||x0||_L2 = {np.sqrt(np.mean(u ** 2)):7.3f},  "
              f"écart avec la grille 2N aux mêmes points = {np.sqrt(np.mean((u - u_fin) ** 2)):.3f}")
# sortie :
# bruit blanc (κ_k = 1)
#   N =    32 : ||x0||_L2 =   5.376,  écart avec la grille 2N aux mêmes points = 4.170
#   N =   128 : ||x0||_L2 =  10.704,  écart avec la grille 2N aux mêmes points = 11.083
#   N =   512 : ||x0||_L2 =  22.955,  écart avec la grille 2N aux mêmes points = 22.677
#   N =  2048 : ||x0||_L2 =  44.400,  écart avec la grille 2N aux mêmes points = 45.695
# champ gaussien (κ_k = k^-2)
#   N =    32 : ||x0||_L2 =   2.171,  écart avec la grille 2N aux mêmes points = 0.191
#   N =   128 : ||x0||_L2 =   2.187,  écart avec la grille 2N aux mêmes points = 0.126
#   N =   512 : ||x0||_L2 =   2.193,  écart avec la grille 2N aux mêmes points = 0.063
#   N =  2048 : ||x0||_L2 =   2.194,  écart avec la grille 2N aux mêmes points = 0.032
La norme du bruit blanc double quand N est multiplié par quatre (\sqrt{N}), et raffiner la grille change complètement les valeurs aux mêmes points : ce n’est pas une fonction. Le champ gaussien de spectre k^{-2} a une norme stable et des valeurs qui convergent, l’écart étant divisé par deux chaque fois que N est multiplié par quatre. Cette décroissance en N^{-1/2} est celle de la norme des modes N/2 \le k < N qu’ajoute le raffinement, \big(2\sum_{N/2 \le k < N} k^{-2}\big)^{1/2} \approx (2/N)^{1/2}.
6.3 Flow matching et diffusion en espace de fonctions
En dimension infinie, il n’existe pas de mesure de Lebesgue : les lois n’ont pas de densité, et les formules qui utilisent p_t(\mathbf{x}) ou \nabla\log p_t doivent être reformulées. Le flow matching s’y prête bien, parce que ses démonstrations n’utilisent que la forme faible de l’équation de continuité (théorèmes 4.2 et 4.4), sans densité.
Functional Flow Matching (Kerrigan, Migliorini & Smyth, 2024) construit un chemin de mesures entre une mesure gaussienne fixée sur un espace de fonctions et la loi des données, par des chemins conditionnels gaussiens, et apprend le champ de vitesse par régression, sans vraisemblance ni simulation. Le champ de vitesse est un opérateur (par exemple un opérateur neuronal de Fourier, FNO) : il s’applique à une fonction échantillonnée sur n’importe quelle grille. Du côté de la diffusion, les Denoising Diffusion Operators de Lim et al. (2025) bruitent par des processus gaussiens et échantillonnent par une dynamique de Langevin à valeurs fonctionnelles, avec un coût d’échantillonnage indépendant de la résolution ; ils sont testés notamment sur des écoulements de Navier–Stokes.
6.4 FunDiff : autoencodeur fonctionnel et rectified flow latent
FunDiff (Wang, Dou, Shan, Liu & Lu, 2026, Nature Communications) combine génération latente et représentation fonctionnelle. Son architecture comporte deux étages.
- Autoencodeur fonctionnel. L’encodeur découpe le champ en morceaux (comme un transformeur de vision), ajoute des plongements de position interpolables, ce qui accepte des discrétisations variables, puis condense l’information dans un petit nombre de jetons latents par attention croisée de type Perceiver. Le décodeur, de type CViT, prend en entrée des coordonnées de requête et renvoie la valeur du champ en ces points par attention croisée sur les latents : le champ décodé est une fonction évaluable en tout point du domaine.
- Modèle génératif latent. Un transformeur de diffusion (DiT) est entraîné sur les latents par rectified flow (chapitre 4), l’autoencodeur étant gelé ; pour la reconstruction à partir de mesures grossières, celles-ci sont encodées et ajoutées au latent. L’échantillonnage utilise typiquement 20 à 50 évaluations.
Les contraintes physiques sont placées à l’endroit où elles sont exactes :
- divergence nulle (dure) : en 2D, le décodeur produit une fonction de courant et la vitesse en est déduite par dérivation (proposition 6.2) ;
- périodicité (dure) : les coordonnées sont plongées par (\cos x, \sin x, \cos y, \sin y) ;
- symétries (dures) : pour l’élasticité linéaire, le décodeur est symétrisé en additionnant ses évaluations aux quatre points images (x, y), (1 - x, y), (x, 1 - y), (1 - x, 1 - y) par les réflexions ;
- résidu d’EDP (douce) : une pénalité \|R(\hat f)\|^2 calculée par différentiation automatique.
Les cas tests comprennent l’écoulement de Kolmogorov à Re = 1000, l’équation de Burgers et l’élasticité linéaire ; sur ce dernier cas, la reconstruction d’un champ 256 \times 256 à partir d’une observation 32 \times 32 bruitée à 10 % atteint une erreur L^2 relative de 5{,}12 % (Wang et al., 2026). L’article établit aussi des vitesses minimax pour l’estimation de densité en dimension infinie. Deux réserves, relevées en lisant l’article : la réduction de la divergence n’y est montrée qu’en figure, sans valeur numérique, et le coût d’entraînement n’est pas rapporté. Signalons enfin que l’un des auteurs, T.-R. Liu, est affilié au laboratoire Navier de l’École nationale des ponts et chaussées, l’établissement du CEREA.
| Espace des états (grille) | Espace latent | Espace de fonctions | |
|---|---|---|---|
| Dimension du modèle génératif | D (millions) | d \ll D | infinie (discrétisée à la volée) |
| Résolution | fixe | fixée par le décodeur | quelconque |
| Source | \mathcal{N}(0, I) | \mathcal{N}(0, I_d) | mesure gaussienne à trace finie |
| Contrainte linéaire exacte | projection ou paramétrisation | architecture du décodeur | architecture de l’opérateur ou du décodeur |
| Exemples | DDPM, EDM | diffusion latente, FunDiff, expérience E2 (latent linéaire : modes de Fourier tronqués) | FFM, DDO, FunDiff (décodeur) |
Ce qu’il faut retenir — chapitre 6
- La génération latente réduit la dimension ; la fidélité est bornée par l’autoencodeur, et les contraintes linéaires se placent au mieux dans le décodeur (fonction de courant, potentiel vecteur), où elles deviennent exactes.
- En dimension infinie, la source doit être une mesure gaussienne à covariance de trace finie ; le bruit blanc n’est pas une fonction.
- Le flow matching passe en espace de fonctions parce que ses démonstrations n’utilisent que la forme faible de l’équation de continuité (FFM) ; DDO fait de même pour la diffusion.
- FunDiff = autoencodeur fonctionnel (décodeur évaluable en tout point) + rectified flow latent ; contraintes dures par architecture, résidu d’EDP en pénalité douce.
7. Évaluer un modèle génératif
Un modèle génératif de champs MHD est utile s’il reproduit la loi des champs (spectres, statistiques, invariants) et si chaque échantillon respecte les contraintes physiques. Aucun de ces deux critères n’est une vraisemblance. Ce chapitre présente les distances entre lois que l’on estime à partir d’échantillons, puis les métriques physiques visées par le stage, et un protocole de comparaison.
7.1 Pourquoi la vraisemblance ne suffit pas
La remarque 1.7 a donné les raisons générales. Pour les modèles de ce module, s’y ajoute le coût : la vraisemblance d’un modèle de flow matching ou de diffusion s’obtient par la formule de la proposition 1.12, en intégrant l’EDO et la divergence du champ de vitesse, ce qui est coûteux en grande dimension. Surtout, Theis, van den Oord et Bethge (2016) montrent que vraisemblance, estimations par fenêtres de Parzen et qualité visuelle des échantillons sont largement indépendantes en grande dimension, et concluent qu’un modèle doit être évalué en fonction de l’usage pour lequel il est conçu. Pour le stage, l’usage est physique.
7.2 Distances entre lois estimées à partir d’échantillons
Définition 7.1 — Distance d’énergie (Székely & Rizzo, 2013) Pour deux lois P et Q sur \mathbb{R}^D à premier moment fini, avec X, X' \sim P et Y, Y' \sim Q indépendants,
\mathcal{E}(P, Q) = 2\,\mathbb{E}\|X - Y\| - \mathbb{E}\|X - X'\| - \mathbb{E}\|Y - Y'\|.
Théorème 7.2 — La distance d’énergie caractérise l’égalité des lois On a \mathcal{E}(P, Q) \ge 0, avec égalité si et seulement si P = Q, et \sqrt{\mathcal{E}} est une distance. De plus, \mathcal{E} vaut deux fois le carré de la maximum mean discrepancy (MMD) associée au noyau induit par la distance, k(\mathbf{x}, \mathbf{y}) = \tfrac12\big(\|\mathbf{x}\| + \|\mathbf{y}\| - \|\mathbf{x} - \mathbf{y}\|\big) (Sejdinovic et al., 2013).
Preuve. Résultat admis. L’idée (Székely & Rizzo, 2013) est l’identité \mathcal{E}(P, Q) = c_D\int_{\mathbb{R}^D}|\varphi_P(\boldsymbol\omega) - \varphi_Q(\boldsymbol\omega)|^2\,\|\boldsymbol\omega\|^{-(D+1)}\,\mathrm{d}\boldsymbol\omega, où \varphi_P et \varphi_Q sont les fonctions caractéristiques et c_D > 0 : l’intégrale est positive, et nulle si et seulement si les fonctions caractéristiques coïncident, c’est-à-dire si P = Q. En dimension 1, une démonstration élémentaire passe par la formule \mathcal{E} = 2\int(F - G)^2 (exercice 16). ∎
Avec des échantillons X_1, \dots, X_n de P et Y_1, \dots, Y_m de Q, l’estimateur sans biais (U-statistique) est
\hat{\mathcal{E}} = \frac{2}{nm}\sum_{i, j}\|X_i - Y_j\| - \frac{1}{n(n-1)}\sum_{i \ne i'}\|X_i - X_{i'}\| - \frac{1}{m(m-1)}\sum_{j \ne j'}\|Y_j - Y_{j'}\|.
Son espérance est exactement \mathcal{E} ; il peut donc être négatif quand les lois coïncident, ce qui est normal et rappelle qu’on doit toujours le comparer à son niveau de fluctuation. Son coût est en O((n + m)^2 D).
Définition 7.3 — Distance de Wasserstein tranchée Pour p \ge 1, la distance de Wasserstein tranchée (Rabin et al., 2012 ; Bonneel et al., 2015) moyenne les distances de Wasserstein entre projections unidimensionnelles :
SW_p^p(P, Q) = \int_{S^{D-1}} W_p^p\big(\theta_\# P,\, \theta_\# Q\big)\,\mathrm{d}\sigma(\theta),
où \theta_\# P est la loi de \langle\theta, X\rangle et \sigma la mesure uniforme sur la sphère.
En dimension 1, W_p^p(P, Q) = \int_0^1|F^{-1}(u) - G^{-1}(u)|^p\,\mathrm{d}u : avec deux échantillons de même taille, il suffit de les trier et de comparer les valeurs de même rang. On estime l’intégrale sur la sphère par Monte-Carlo sur L directions, pour un coût O(L\,n\log n), bien moindre que celui du transport optimal en dimension D (module p5). L’estimateur empirique est biaisé positivement : il ne vaut pas 0 pour deux échantillons de la même loi.
Dans les applications en images, la métrique standard est le FID (Heusel et al., 2017) : la distance de Fréchet entre deux gaussiennes ajustées sur des descripteurs d’un réseau de classification d’images. Ces descripteurs n’ont aucun sens physique pour un champ MHD ; le stage utilise donc des distances sur les champs eux-mêmes ou sur des descripteurs physiques.
Exemple 7.4 — Sensibilité des deux distances Le bloc suivant compare, en dimension 2, un mélange de quatre gaussiennes de référence à cinq variantes : même loi, décalage de 0{,}1, écart-type multiplié par 1{,}5, un mode perdu, poids déséquilibrés.
import numpy as np
from scipy.spatial.distance import cdist

rng = np.random.default_rng(0)

def distance_energie(X, Y):
    """Estimateur sans biais de D_E(P, Q) = 2E|X-Y| - E|X-X'| - E|Y-Y'|."""
    n, m = len(X), len(Y)
    return 2 * cdist(X, Y).mean() - cdist(X, X).sum() / (n * (n - 1)) - cdist(Y, Y).sum() / (m * (m - 1))

def wasserstein_tranche(X, Y, n_dir=200):
    """SW_1 : moyenne sur des directions aléatoires de W_1 entre projections 1D (tri, tailles égales)."""
    th = rng.standard_normal((n_dir, X.shape[1])); th /= np.linalg.norm(th, axis=1, keepdims=True)
    px, py = np.sort(X @ th.T, axis=0), np.sort(Y @ th.T, axis=0)
    return np.abs(px - py).mean()

def melange(n, poids=(0.25, 0.25, 0.25, 0.25), decalage=0.0, ecart=0.15):
    k = rng.choice(4, size=n, p=poids)
    ang = k * np.pi / 2
    return np.stack([np.cos(ang), np.sin(ang)], 1) * 1.5 + decalage + ecart * rng.standard_normal((n, 2))

n = 2000
ref = melange(n)
cas = {"même loi": melange(n),
       "décalage de 0,1": melange(n, decalage=0.1),
       "écart-type ×1,5": melange(n, ecart=0.225),
       "un mode perdu": melange(n, poids=(1/3, 1/3, 1/3, 0)),
       "poids 0,4/0,1/0,25/0,25": melange(n, poids=(0.4, 0.1, 0.25, 0.25))}
print(f"{'cas':26s} {'D_E':>8s} {'SW_1':>8s}")
for nom, X in cas.items():
    print(f"{nom:26s} {distance_energie(X, ref):8.4f} {wasserstein_tranche(X, ref):8.4f}")
# sortie :
# cas                             D_E     SW_1
# même loi                    -0.0010   0.0238
# décalage de 0,1              0.0135   0.0912
# écart-type ×1,5              0.0049   0.0749
# un mode perdu                0.1860   0.3824
# poids 0,4/0,1/0,25/0,25      0.0665   0.1989
Les deux distances classent les défauts dans le même ordre : la perte d’un mode est le plus grave, puis un mauvais équilibre des poids, puis un décalage, puis un élargissement des modes. La distance d’énergie fluctue autour de 0 pour la même loi (-0{,}001), tandis que la distance tranchée garde un biais positif (0{,}024) dû à la taille finie des échantillons. Dans les deux cas, un chiffre isolé ne dit rien : il faut le comparer au plancher obtenu entre deux échantillons indépendants de la référence.
7.3 Métriques physiques
Les distances précédentes sont génériques. Pour des champs MHD, elles doivent être complétées par des métriques qui testent ce que la physique impose ; l’offre de stage cite les spectres d’énergie, l’hélicité, le contrôle de la divergence et la préservation de la topologie.
| Ce que l’on teste | Métrique | Remarque |
|---|---|---|
| Contrainte sur chaque échantillon | divergence relative \|\nabla\cdot\mathbf{B}\|/\|\nabla\mathbf{B}\|, erreur sur les conditions aux limites | distribution sur tous les échantillons, pas seulement la moyenne |
| Statistiques d’ordre 2 | spectres E_u(k), E_B(k) ; erreur par bande logarithmique | les erreurs se concentrent aux petites échelles |
| Invariants | lois de E, H_K, H_M, H_C, comparées par W_1 | H_M dépend de la jauge si \mathbf{B}\cdot\mathbf{n} \ne 0 au bord |
| Bilans | injection moyenne = dissipation moyenne (contrainte en loi) | identité de stationnarité, voir E1 et E2 |
| Intermittence | densités des incréments, aplatissement | les queues de distribution sont les plus difficiles |
| Topologie | points nuls du champ, diagrammes de persistance | distance entre diagrammes stable (Cohen-Steiner et al., 2007) |
| Dynamique | fréquence des renversements, temps de corrélation | demande une information temporelle (E1 : formule de Rice) |
Dans le même esprit, Lienen et al. (2024) évaluent leurs modèles de diffusion d’écoulements turbulents 3D par une distance de Wasserstein entre spectres d’énergie cinétique turbulente, et la revue de Biferale et Buzzicotti (2026) plaide pour une validation fondée sur les transferts d’énergie, les fonctions de structure, les queues de distribution et les lois de conservation.
7.4 Protocole et comparaison avec DDPM
Un protocole minimal comprend : le plancher (deux échantillons indépendants de la référence) ; une référence naïve (par exemple une gaussienne ajustée) ; des valeurs de \boldsymbol\lambda dans et hors de l’entraînement ; plusieurs graines ; et un budget comparable, mesuré en évaluations du réseau. Le bloc suivant entraîne un petit DDPM sur les données du travail pratique de la section 5.6, avec le même réseau et le même budget d’entraînement que le flow matching, et l’échantillonne de deux façons.
import math, time
import torch
import torch.nn as nn

torch.manual_seed(0); torch.set_num_threads(1)

def echantillons(lam, n):            # mêmes données qu'au chapitre 5
    lam = torch.as_tensor(lam, dtype=torch.float32).expand(n)
    k = torch.randint(0, 4, (n,))
    ang = k * math.pi / 2 + lam * math.pi / 4
    return (1.0 + lam)[:, None] * torch.stack([torch.cos(ang), torch.sin(ang)], 1) + 0.15 * torch.randn(n, 2)

LAM_TRAIN = torch.tensor([0.0, 0.25, 0.5, 0.75, 1.0])
net = nn.Sequential(nn.Linear(4, 128), nn.SiLU(), nn.Linear(128, 128), nn.SiLU(),
                    nn.Linear(128, 128), nn.SiLU(), nn.Linear(128, 2))       # même réseau
eps_theta = lambda y, s, lam: net(torch.cat([y, s[:, None], lam[:, None]], 1))

K = 100                                           # DDPM à 100 pas
beta = torch.linspace(1e-3, 0.2, K)               # planning linéaire (celui de Ho et al. × 1000/K)
alpha = 1 - beta
abar = torch.cumprod(alpha, 0)
print(f"ᾱ_K = {abar[-1]:.1e}")

opt = torch.optim.Adam(net.parameters(), lr=2e-3)
n_iter, B = 3000, 256                             # même budget que le flow matching
sched = torch.optim.lr_scheduler.CosineAnnealingLR(opt, n_iter)
t0 = time.time()
for it in range(n_iter):
    lam = LAM_TRAIN[torch.randint(0, 5, (B,))]
    y0 = echantillons(lam, B)                     # donnée (convention de la diffusion : indice 0)
    k = torch.randint(0, K, (B,))
    eps = torch.randn(B, 2)
    yk = abar[k].sqrt()[:, None] * y0 + (1 - abar[k]).sqrt()[:, None] * eps
    perte = ((eps_theta(yk, k / K, lam) - eps) ** 2).sum(1).mean()          # L_simple
    opt.zero_grad(); perte.backward(); opt.step(); sched.step()
print(f"entraînement : {time.time() - t0:.1f} s, perte finale {perte.item():.3f}")

@torch.no_grad()
def ancestral(lam, n):                            # K évaluations du réseau
    y, L = torch.randn(n, 2), torch.full((n,), float(lam))
    for k in reversed(range(K)):
        e = eps_theta(y, torch.full((n,), k / K), L)
        y = (y - beta[k] / (1 - abar[k]).sqrt() * e) / alpha[k].sqrt()
        if k > 0:
            y = y + beta[k].sqrt() * torch.randn(n, 2)
    return y

@torch.no_grad()
def ddim(lam, n, pas=10):                         # échantillonneur déterministe (Song, Meng, Ermon 2021)
    y, L = torch.randn(n, 2), torch.full((n,), float(lam))
    ks = torch.linspace(K - 1, 0, pas).round().long()
    for i, k in enumerate(ks):
        e = eps_theta(y, torch.full((n,), k.item() / K), L)
        y0 = (y - (1 - abar[k]).sqrt() * e) / abar[k].sqrt()             # estimée débruitée
        ab_suiv = abar[ks[i + 1]] if i + 1 < pas else torch.tensor(1.0)
        y = ab_suiv.sqrt() * y0 + (1 - ab_suiv).sqrt() * e
    return y

def distance_energie(X, Y):
    n, m = len(X), len(Y)
    return (2 * torch.cdist(X, Y).mean() - torch.cdist(X, X).sum() / (n * (n - 1))
            - torch.cdist(Y, Y).sum() / (m * (m - 1))).item()

n = 2000
for lam in [0.25, 0.5, 0.375, 0.625]:
    ref = echantillons(lam, n)
    print(f"λ = {lam:5.3f} : DDPM ancestral (100 éval.) D_E = {distance_energie(ancestral(lam, n), ref):.4f}   "
          f"DDIM (10 éval.) D_E = {distance_energie(ddim(lam, n), ref):.4f}")
# sortie :
# ᾱ_K = 2.0e-05
# entraînement : 14.4 s, perte finale 0.365
# λ = 0.250 : DDPM ancestral (100 éval.) D_E = -0.0003   DDIM (10 éval.) D_E = 0.0112
# λ = 0.500 : DDPM ancestral (100 éval.) D_E = 0.0023   DDIM (10 éval.) D_E = 0.0198
# λ = 0.375 : DDPM ancestral (100 éval.) D_E = 0.0033   DDIM (10 éval.) D_E = 0.0174
# λ = 0.625 : DDPM ancestral (100 éval.) D_E = -0.0011   DDIM (10 éval.) D_E = 0.0115
En rapprochant ces chiffres de ceux de la section 5.6 (même réseau, même budget d’entraînement, même graine), on obtient le tableau suivant.
| Méthode | Évaluations du réseau | \hat{\mathcal{E}} aux quatre valeurs de \lambda |
|---|---|---|
| Flow matching, Heun 50 pas | 99 | -0{,}0002 à 0{,}0010 (plancher) |
| DDPM, ancestral | 100 | -0{,}0011 à 0{,}0033 (proche du plancher) |
| Flow matching, Euler 10 pas | 10 | 0{,}0033 à 0{,}0043 |
| DDPM, DDIM 10 pas | 10 | 0{,}0112 à 0{,}0198 |
| Plancher (référence / référence) | — | -0{,}0017 à 0{,}0009 |
| Gaussienne ajustée | — | 0{,}074 à 0{,}108 |
À une centaine d’évaluations, les deux familles atteignent le plancher de bruit. À dix évaluations, le flow matching avec le plus simple des solveurs fait environ quatre fois mieux que DDIM sur le même budget. Ce résultat est cohérent avec l’argument du chapitre 4 (chemins plus droits, intégration plus facile), mais il ne porte que sur un exemple jouet en dimension 2, avec une seule graine et des réglages non optimisés : il illustre un protocole, il ne tranche pas entre les méthodes.
Ce qu’il faut retenir — chapitre 7
- La vraisemblance est coûteuse et peu informative sur la qualité des échantillons ; on évalue un modèle génératif par l’usage visé.
- La distance d’énergie 2\mathbb{E}\|X - Y\| - \mathbb{E}\|X - X'\| - \mathbb{E}\|Y - Y'\| est nulle si et seulement si les lois coïncident ; son estimateur sans biais fluctue autour de 0.
- La distance de Wasserstein tranchée se calcule par projections et tris ; son estimateur empirique est biaisé positivement.
- Pour la physique, on ajoute contraintes par échantillon, spectres, invariants, bilans en loi, intermittence et topologie, toujours comparés au plancher de bruit, dans et hors de la plage de paramètres d’entraînement.
Exercices
Les exercices sont gradués : ★ application directe du cours, ★★ calcul ou démonstration en plusieurs étapes, ★★★ question proche de la recherche ou exercice de programmation. Cherchez chaque exercice avant de lire la solution.
★ Transport par la fonction de répartition. Soit Z \sim \mathcal{N}(0, 1) et T(z) = -\ln\big(1 - \Phi(z)\big). (a) Montrer que T est strictement croissante. (b) Calculer la densité de X = T(Z) par le théorème 1.8 et reconnaître la loi. (c) Quelle est l’image de la médiane de Z ?
Solution : (a) T'(z) = \varphi(z)/(1 - \Phi(z)) > 0, où \varphi est la densité gaussienne. (b) Pour x > 0, posons z = T^{-1}(x), de sorte que 1 - \Phi(z) = e^{-x}. Le théorème 1.8 donne q(x) = \varphi(z)/T'(z) = 1 - \Phi(z) = e^{-x} : c’est la loi exponentielle de paramètre 1, comme l’annonce la proposition 1.3 avec F(x) = 1 - e^{-x}. (c) T(0) = -\ln(1/2) = \ln 2, la médiane de la loi exponentielle : un transport croissant envoie les quantiles sur les quantiles.
★ Flot affine et maximum de vraisemblance. On modélise des données réelles x_1, \dots, x_N par q_{a,b} = (T_{a,b})_\#\mathcal{N}(0, 1) avec T_{a,b}(z) = az + b, a > 0. Écrire la log-vraisemblance moyenne et la maximiser.
Solution : Par l’exemple 1.9 en dimension 1, \log q_{a,b}(x) = -\tfrac12\log(2\pi) - \frac{(x - b)^2}{2a^2} - \log a. En notant \bar x la moyenne empirique et S = \frac1N\sum_i(x_i - \bar x)^2, la log-vraisemblance moyenne vaut \ell(a, b) = -\tfrac12\log(2\pi) - \frac{S + (\bar x - b)^2}{2a^2} - \log a. Elle est maximale en b = \bar x ; puis \partial_a\ell = S/a^3 - 1/a = 0 donne a^2 = S. Le maximum vaut -\tfrac12\log(2\pi) - \tfrac12 - \tfrac12\log S : le flot affine optimal est la gaussienne de mêmes moyenne et variance empiriques, et la vraisemblance ne dépend des données que par S.
★ Planning de bruit constant. Dans DDPM, on prend \beta_k = \beta = 0{,}01 pour tout k. (a) Exprimer \bar\alpha_k et \operatorname{RSB}_k. (b) Combien de pas faut-il pour que \bar\alpha_K \le 10^{-4} ? (c) À quel pas le rapport signal sur bruit vaut-il 1 ? Comparer au planning linéaire de l’exemple 2.3.
Solution : (a) \bar\alpha_k = (1 - \beta)^k = 0{,}99^k et \operatorname{RSB}_k = 0{,}99^k/(1 - 0{,}99^k). (b) 0{,}99^K \le 10^{-4} équivaut à K \ge \ln(10^{-4})/\ln(0{,}99) = 916{,}4, soit K = 917. (c) \operatorname{RSB}_k = 1 équivaut à \bar\alpha_k = 1/2, soit k = \ln 2/(-\ln 0{,}99) = 69{,}0. Avec le planning constant, le signal est à moitié détruit dès 7 % des pas, contre 25 % pour le planning linéaire (\operatorname{RSB}_{250} = 1{,}10) : un planning croissant consacre plus de pas aux faibles bruits, là où se forment les détails.
★★ Prédire le bruit ou prédire la donnée. On note \hat{\mathbf{y}}_0 = (\mathbf{y}_k - \sqrt{1 - \bar\alpha_k}\,\hat{\boldsymbol\varepsilon})/\sqrt{\bar\alpha_k} l’estimée de la donnée associée à une prédiction \hat{\boldsymbol\varepsilon} du bruit. Montrer que \|\boldsymbol\varepsilon - \hat{\boldsymbol\varepsilon}\|^2 = \operatorname{RSB}_k\,\|\mathbf{y}_0 - \hat{\mathbf{y}}_0\|^2. Qu’en déduire sur la pondération implicite de L_{\mathrm{simple}} ?
Solution : Comme \mathbf{y}_0 = (\mathbf{y}_k - \sqrt{1 - \bar\alpha_k}\,\boldsymbol\varepsilon)/\sqrt{\bar\alpha_k}, on a \mathbf{y}_0 - \hat{\mathbf{y}}_0 = \sqrt{(1 - \bar\alpha_k)/\bar\alpha_k}\,(\hat{\boldsymbol\varepsilon} - \boldsymbol\varepsilon), d’où
\|\mathbf{y}_0 - \hat{\mathbf{y}}_0\|^2 = \frac{1 - \bar\alpha_k}{\bar\alpha_k}\,\|\boldsymbol\varepsilon - \hat{\boldsymbol\varepsilon}\|^2 = \frac{1}{\operatorname{RSB}_k}\,\|\boldsymbol\varepsilon - \hat{\boldsymbol\varepsilon}\|^2.
La perte L_{\mathrm{simple}}, uniforme en k pour le bruit, est donc une perte sur la donnée pondérée par le rapport signal sur bruit : les niveaux de faible bruit (grand RSB) pèsent beaucoup, les niveaux de fort bruit presque pas. Ce choix de pondération est l’un des « boutons » que Kingma et al. (2021) et EDM (section 3.4) rendent explicites.
★★ Débruiteur optimal pour des données à deux points. Soit \mu = \tfrac12(\delta_{-1} + \delta_{+1}) et y = y_0 + \sigma\varepsilon. (a) Calculer \mathbb{E}[y_0 \mid y]. (b) En déduire le score de la loi de y par la formule de Tweedie. (c) Étudier les limites \sigma \to 0 et \sigma \to \infty.
Solution : (a) Par Bayes, \mathbb{P}(y_0 = 1 \mid y) \propto e^{-(y-1)^2/(2\sigma^2)} et \mathbb{P}(y_0 = -1 \mid y) \propto e^{-(y+1)^2/(2\sigma^2)} ; leur rapport vaut e^{2y/\sigma^2}, donc \mathbb{P}(y_0 = 1 \mid y) = 1/(1 + e^{-2y/\sigma^2}) et
\mathbb{E}[y_0 \mid y] = \mathbb{P}(y_0 = 1 \mid y) - \mathbb{P}(y_0 = -1 \mid y) = \tanh(y/\sigma^2).
- Avec a = 1, la proposition 3.7 donne \partial_y\log p(y) = \big(\tanh(y/\sigma^2) - y\big)/\sigma^2, ce que l’on vérifie en dérivant directement \log\big(e^{-(y-1)^2/(2\sigma^2)} + e^{-(y+1)^2/(2\sigma^2)}\big). (c) Quand \sigma \to 0, \tanh(y/\sigma^2) \to \operatorname{signe}(y) : le débruiteur choisit le point le plus proche. Quand \sigma \to \infty, \tanh(y/\sigma^2) \approx y/\sigma^2 \to 0 : à très fort bruit, le débruiteur optimal renvoie la moyenne des données.
★★ ODE de flot de probabilité pour des données gaussiennes. Dans la paramétrisation d’EDM, y = x + \sigma n avec x \sim \mathcal{N}(0, \tau^2). (a) Calculer le débruiteur D(y; \sigma) et le score. (b) Résoudre l’ODE \mathrm{d}y/\mathrm{d}\sigma = (y - D(y; \sigma))/\sigma de \sigma_{\max} à 0. (c) Si l’on part de y \sim \mathcal{N}(0, \sigma_{\max}^2) au lieu de \mathcal{N}(0, \tau^2 + \sigma_{\max}^2), quelle variance obtient-on à l’arrivée ? Application : \tau = 0{,}5, \sigma_{\max} = 80.
Solution : (a) y \sim \mathcal{N}(0, \tau^2 + \sigma^2), donc \partial_y\log p = -y/(\tau^2 + \sigma^2) et, par Tweedie, D(y; \sigma) = y + \sigma^2\partial_y\log p = \tau^2 y/(\tau^2 + \sigma^2). (b) L’ODE devient \mathrm{d}y/\mathrm{d}\sigma = \sigma y/(\tau^2 + \sigma^2), soit \mathrm{d}\ln|y| = \tfrac12\,\mathrm{d}\ln(\tau^2 + \sigma^2), d’où
y(\sigma) = y(\sigma_{\max})\sqrt{\frac{\tau^2 + \sigma^2}{\tau^2 + \sigma_{\max}^2}}.
En \sigma = 0, y(0) = y(\sigma_{\max})\,\tau/\sqrt{\tau^2 + \sigma_{\max}^2} : si y(\sigma_{\max}) \sim \mathcal{N}(0, \tau^2 + \sigma_{\max}^2), alors y(0) \sim \mathcal{N}(0, \tau^2), la loi des données. (c) En partant de \mathcal{N}(0, \sigma_{\max}^2), on obtient la variance \tau^2\sigma_{\max}^2/(\tau^2 + \sigma_{\max}^2) = \tau^2\big(1 - \tau^2/(\tau^2 + \sigma_{\max}^2)\big) ; pour \tau = 0{,}5 et \sigma_{\max} = 80, l’erreur relative vaut 0{,}25/6400{,}25 \approx 4 \times 10^{-5}, ce qui justifie de partir d’une gaussienne de variance \sigma_{\max}^2.
★★ Score matching par intégration par parties (Hyvärinen, 2005). En dimension 1, soit p une densité régulière de score \psi = (\log p)' et s_\theta un modèle tel que s_\theta\,p \to 0 en \pm\infty. Montrer que J_{\mathrm{ESM}}(\theta) = \mathbb{E}_p\big[s_\theta^2 + 2\,s_\theta'\big] + C, où C ne dépend pas de \theta. Pourquoi cette forme est-elle coûteuse en dimension D ?
Solution : On développe J_{\mathrm{ESM}} = \mathbb{E}_p[s_\theta^2] - 2\,\mathbb{E}_p[s_\theta\psi] + \mathbb{E}_p[\psi^2]. Comme p\,\psi = p', une intégration par parties donne \mathbb{E}_p[s_\theta\psi] = \int s_\theta\,p'\,\mathrm{d}y = [s_\theta\,p]_{-\infty}^{+\infty} - \int s_\theta'\,p\,\mathrm{d}y = -\mathbb{E}_p[s_\theta'], d’où le résultat avec C = \mathbb{E}_p[\psi^2]. Le score inconnu a disparu. En dimension D, le terme s_\theta' devient la trace de la jacobienne \sum_i\partial_i s_{\theta, i}, qui demande D rétropropagations : c’est ce que le score matching par débruitage (théorème 3.6) évite.
★ Chemin gaussien de Lipman et al. On considère \mathbf{x}_t = \big(1 - (1 - \sigma_{\min})t\big)\mathbf{x}_0 + t\,\mathbf{x}_1 avec 0 < \sigma_{\min} \ll 1. (a) Quelle est la loi de \mathbf{x}_t sachant \mathbf{x}_1, et en t = 1 ? (b) Calculer la vitesse conditionnelle u_t(\mathbf{x} \mid \mathbf{x}_1). (c) Quelle cible de régression utilise-t-on à l’entraînement ?
Solution : (a) Sachant \mathbf{x}_1, \mathbf{x}_t \sim \mathcal{N}\big(t\mathbf{x}_1, \sigma_t^2 I\big) avec \sigma_t = 1 - (1 - \sigma_{\min})t ; en t = 1, c’est \mathcal{N}(\mathbf{x}_1, \sigma_{\min}^2 I), une gaussienne étroite qui évite la singularité de la proposition 4.5. (b) La vitesse le long du chemin est \dot{\mathbf{x}}_t = \mathbf{x}_1 - (1 - \sigma_{\min})\mathbf{x}_0 ; on remplace \mathbf{x}_0 = (\mathbf{x} - t\mathbf{x}_1)/\sigma_t et l’on utilise \sigma_t + (1 - \sigma_{\min})t = 1 :
u_t(\mathbf{x} \mid \mathbf{x}_1) = \frac{\mathbf{x}_1 - (1 - \sigma_{\min})\,\mathbf{x}}{1 - (1 - \sigma_{\min})\,t}.
- À l’entraînement, on régresse v_\theta(\mathbf{x}_t, t) sur \mathbf{x}_1 - (1 - \sigma_{\min})\mathbf{x}_0, sans division : le théorème 4.7 s’applique tel quel.
★★ Cible gaussienne : flot explicite. Soit \mu = \mathcal{N}(\mathbf{m}, s^2 I) et \sigma_t^2 = (1 - t)^2 + t^2 s^2. (a) Vérifier que \mathbf{x}(t) = t\,\mathbf{m} + \sigma_t\,\mathbf{x}_0 est solution de l’EDO \dot{\mathbf{x}} = v_t(\mathbf{x}) avec le champ de la proposition 4.8 (une seule composante). (b) En déduire que le flot transporte \mathcal{N}(0, I) sur \mu. (c) Les trajectoires sont-elles des droites ? Que fait un redressement ?
Solution : (a) Pour une seule composante, v_t(\mathbf{x}) = \mathbf{m} + \frac{t s^2 - (1 - t)}{\sigma_t^2}(\mathbf{x} - t\mathbf{m}). Le long de \mathbf{x}(t), \mathbf{x}(t) - t\mathbf{m} = \sigma_t\mathbf{x}_0, donc v_t(\mathbf{x}(t)) = \mathbf{m} + \frac{t s^2 - (1 - t)}{\sigma_t}\mathbf{x}_0. Or \dot{\mathbf{x}}(t) = \mathbf{m} + \dot\sigma_t\mathbf{x}_0 avec \dot\sigma_t = \frac{-(1 - t) + t s^2}{\sigma_t} : les deux expressions coïncident. (b) \mathbf{x}(1) = \mathbf{m} + s\,\mathbf{x}_0 \sim \mathcal{N}(\mathbf{m}, s^2 I). (c) Une trajectoire t\mathbf{m} + \sigma_t\mathbf{x}_0 est droite pour tout \mathbf{x}_0 si et seulement si \sigma_t est affine en t. Or \sigma_t^2 = 1 - 2t + (1 + s^2)t^2 est le carré d’une fonction affine (1 - ct)^2 seulement si c = 1 et c^2 = 1 + s^2, c’est-à-dire s = 0 : pour toute cible non dégénérée, les trajectoires sont courbes (le nuage se contracte puis se dilate, ce que montre le schéma interactif 4.11). L’application finale \mathbf{x}_0 \mapsto \mathbf{m} + s\mathbf{x}_0 est pourtant le transport optimal ; un redressement réentraîne sur les paires (\mathbf{x}_0, \mathbf{m} + s\mathbf{x}_0), dont l’interpolant \mathbf{x}_0 + t(\mathbf{m} + (s - 1)\mathbf{x}_0) est rectiligne : les nouvelles trajectoires sont droites et un seul pas d’Euler suffit.
★★ Chemin trigonométrique. On prend l’interpolant \mathbf{x}_t = \cos(\pi t/2)\,\mathbf{x}_0 + \sin(\pi t/2)\,\mathbf{x}_1 avec \mathbf{x}_0 \sim \mathcal{N}(0, I). (a) Vérifier que, si \mathbf{x}_1 est centré réduit et indépendant de \mathbf{x}_0, la variance est préservée. (b) Exprimer le champ b_t en fonction du score de p_t à l’aide de la proposition 4.13.
Solution : (a) \mathrm{Var}(\mathbf{x}_t) = \cos^2(\pi t/2) + \sin^2(\pi t/2) = 1 par composante : c’est un chemin à variance préservée, comme celui de DDPM. (b) Avec \alpha = \cos(\pi t/2) et \beta = \sin(\pi t/2), on a \dot\beta/\beta = \frac{\pi}{2}\cot(\pi t/2) et \dot\alpha - \alpha\dot\beta/\beta = -\frac{\pi}{2}\big(\sin + \cos^2/\sin\big) = -\frac{\pi}{2}\,\frac{1}{\sin(\pi t/2)}. La proposition 4.13 donne alors
b_t(\mathbf{x}) = \frac{\pi}{2}\cot\Big(\frac{\pi t}{2}\Big)\big(\mathbf{x} + \nabla\log p_t(\mathbf{x})\big).
Pour une cible gaussienne centrée réduite, p_t = \mathcal{N}(0, I) pour tout t, le score vaut -\mathbf{x} et le champ est nul : rien ne bouge, ce qui est cohérent.
★★★ Rectified flow en dimension 1. Soit \mu une loi sur \mathbb{R} à densité, \phi_1 le flot au temps 1 du champ marginal (théorème 4.4) partant de \mathcal{N}(0, 1). (a) Montrer que \phi_1 est strictement croissante et en déduire \phi_1 = F_\mu^{-1}\circ\Phi. (b) Montrer qu’après un redressement, les trajectoires du nouveau flot marginal sont des droites. (c) Pourquoi ce couplage minimise-t-il tous les coûts convexes \mathbb{E}\,c(Z_1 - Z_0) ?
Solution : (a) Deux trajectoires d’une EDO à champ régulier ne peuvent se croiser (unicité de Cauchy–Lipschitz) ; en dimension 1, si x < x' alors \phi_t(x) < \phi_t(x') pour tout t, sinon les trajectoires se rencontreraient par le théorème des valeurs intermédiaires. Donc \phi_1 est strictement croissante et pousse \mathcal{N}(0, 1) sur \mu. Pour tout z, F_\mu(\phi_1(z)) = \mathbb{P}(\phi_1(Z) \le \phi_1(z)) = \mathbb{P}(Z \le z) = \Phi(z), d’où \phi_1 = F_\mu^{-1}\circ\Phi. (b) Le nouveau couplage est (Z_0, T(Z_0)) avec T = \phi_1 croissante. L’interpolant Z_t = \big((1 - t)\,\mathrm{id} + t\,T\big)(Z_0) est l’image de Z_0 par une fonction strictement croissante, donc inversible : connaître Z_t détermine Z_0, et \mathbb{E}[Z_1 - Z_0 \mid Z_t] = T(Z_0) - Z_0 exactement. Le champ marginal fait donc suivre à chaque point la droite z_0 + t\,(T(z_0) - z_0), et un pas d’Euler intègre l’EDO sans erreur. (c) En dimension 1, le couplage monotone (le « réarrangement croissant ») minimise \mathbb{E}\,c(Z_1 - Z_0) simultanément pour toutes les fonctions convexes c ; c’est un résultat classique du transport optimal unidimensionnel (module p5), cohérent avec le théorème 4.12. En dimension supérieure, le flot marginal n’est pas en général le transport optimal, et un seul redressement ne suffit pas, en général, à rendre les trajectoires droites.
★★ Guidage sans classifieur sur des gaussiennes. On suppose p(x \mid c) = \mathcal{N}(c, 1) et c \sim \mathcal{N}(0, \tau^2), de sorte que p(x) = \mathcal{N}(0, 1 + \tau^2). (a) Calculer le score guidé \tilde s = (1 + w)\,s(x \mid c) - w\,s(x) et montrer que c’est le score d’une gaussienne dont on donnera la moyenne et la variance. (b) Interpréter pour \tau = 1 et w = 1.
Solution : (a) s(x \mid c) = c - x et s(x) = -x/(1 + \tau^2), donc \tilde s(x) = (1 + w)(c - x) + w\,x/(1 + \tau^2), fonction affine de x de pente -\big(1 + w\tau^2/(1 + \tau^2)\big). C’est le score de la gaussienne de variance
\tilde v = \frac{1 + \tau^2}{1 + \tau^2 + w\tau^2}
et de moyenne \tilde m = (1 + w)\,\tilde v\,c (on identifie \tilde s(x) = -(x - \tilde m)/\tilde v).
- Pour \tau = 1 et w = 1 : \tilde v = 2/3 et \tilde m = 4c/3. Le guidage réduit la dispersion (variance 2/3 au lieu de 1) et exagère la condition (moyenne poussée au-delà de c, loin de la moyenne non conditionnelle 0). C’est exactement ce que mesure l’exercice 14 sur le mélange en dimension 2.
★★ Écart de Jensen pour une cible gaussienne. Soit x_1 \sim \mathcal{N}(m, s^2) en dimension 1 et x_t = (1 - t)x_0 + t x_1. (a) Calculer \mathrm{Var}(x_1 \mid x_t). (b) En déduire l’écart de Jensen pour R(x) = x^2 et le déficit d’« énergie » de l’estimée débruitée. (c) Application numérique pour s = 0{,}5, t = 0{,}5 et t = 0{,}9 ; comparer à l’exemple 5.10.
Solution : (a) Le couple (x_1, x_t) est gaussien, avec \mathrm{Var}(x_t) = \sigma_t^2 = (1 - t)^2 + t^2 s^2 et \mathrm{Cov}(x_1, x_t) = t s^2. La variance conditionnelle gaussienne vaut
\mathrm{Var}(x_1 \mid x_t) = s^2 - \frac{t^2 s^4}{\sigma_t^2} = \frac{s^2\,(1 - t)^2}{\sigma_t^2},
indépendante de la valeur de x_t. (b) Par la proposition 5.9 (iii), \mathcal{J}_R = s^2(1 - t)^2/\sigma_t^2, et \mathbb{E}[\hat x_1^2] = \mathbb{E}[x_1^2] - s^2(1 - t)^2/\sigma_t^2 : l’estimée débruitée manque exactement de cette énergie. (c) Pour t = 0{,}5 : \sigma_t^2 = 0{,}3125 et l’écart vaut 0{,}2, soit 80 % de s^2. Pour t = 0{,}9 : \sigma_t^2 = 0{,}2125 et l’écart vaut 0{,}0118. Dans l’exemple 5.10, la cible est un mélange de deux gaussiennes de même écart-type 0{,}5 ; à t = 0{,}9, le mode est déjà choisi et l’écart mesuré, 0{,}0118, coïncide avec la valeur intra-mode calculée ici. À t = 0{,}5, l’écart du mélange (0{,}45) est plus grand, car l’incertitude sur le mode s’ajoute à la variance intra-mode.
★★★ Programmation : le guidage déforme la loi. Reprendre le travail pratique de la section 5.6 en entraînant un seul réseau conditionnel et non conditionnel (p_{\mathrm{uncond}} = 0{,}2), puis échantillonner en \lambda = 0{,}5 avec le champ guidé \tilde v = (1 + w)\,v(\mathbf{x}, t, \lambda) - w\,v(\mathbf{x}, t, \varnothing) pour w \in \{0, 1, 3\}. Mesurer la largeur des modes, leur décalage par rapport aux positions exactes, la proportion de points éloignés de tous les modes, le rayon médian et la distance d’énergie aux données.
Solution : Le jeton vide est codé par une entrée supplémentaire c \in \{0, 1\} (et \lambda mis à 0 quand c = 0). L’écart-type intra-mode est estimé de façon robuste par la médiane de la distance au centre du mode, qui suit une loi de Rayleigh de médiane \sigma\sqrt{2\ln 2}. On le calcule deux fois : autour des centres exacts, puis autour des centres empiriques des modes générés, ce qui sépare un élargissement d’un simple déplacement des modes.
import math
import torch
import torch.nn as nn

torch.manual_seed(0); torch.set_num_threads(1)

def echantillons(lam, n):
    lam = torch.as_tensor(lam, dtype=torch.float32).expand(n)
    k = torch.randint(0, 4, (n,))
    ang = k * math.pi / 2 + lam * math.pi / 4
    return (1.0 + lam)[:, None] * torch.stack([torch.cos(ang), torch.sin(ang)], 1) + 0.15 * torch.randn(n, 2)

LAM_TRAIN = torch.tensor([0.0, 0.25, 0.5, 0.75, 1.0])
net = nn.Sequential(nn.Linear(5, 128), nn.SiLU(), nn.Linear(128, 128), nn.SiLU(),
                    nn.Linear(128, 128), nn.SiLU(), nn.Linear(128, 2))
# entrée : (x, t, λ, c) avec c = 1 si la condition est fournie, c = 0 (et λ = 0) sinon : jeton « ∅ »
v = lambda x, t, lam, c: net(torch.cat([x, t[:, None], (lam * c)[:, None], c[:, None]], 1))

opt = torch.optim.Adam(net.parameters(), lr=2e-3)
n_iter, B, p_uncond = 3000, 256, 0.2
sched = torch.optim.lr_scheduler.CosineAnnealingLR(opt, n_iter)
for it in range(n_iter):
    lam = LAM_TRAIN[torch.randint(0, 5, (B,))]
    x1, x0, t = echantillons(lam, B), torch.randn(B, 2), torch.rand(B)
    c = (torch.rand(B) > p_uncond).float()                 # condition retirée avec probabilité p_uncond
    xt = (1 - t[:, None]) * x0 + t[:, None] * x1
    perte = ((v(xt, t, lam, c) - (x1 - x0)) ** 2).sum(1).mean()
    opt.zero_grad(); perte.backward(); opt.step(); sched.step()

@torch.no_grad()
def echantillonner(lam, n, w, pas=50):
    x, L = torch.randn(n, 2), torch.full((n,), float(lam))
    un, zero = torch.ones(n), torch.zeros(n)
    def champ(x, t):                                       # ṽ = (1 + w) v(x,t,λ) - w v(x,t,∅)
        return (1 + w) * v(x, t, L, un) - w * v(x, t, L, zero)
    h = 1.0 / pas
    for i in range(pas):
        t = torch.full((n,), i * h)
        d0 = champ(x, t)
        x = x + 0.5 * h * (d0 + champ(x + h * d0, t + h))
    return x

def distance_energie(X, Y):
    n, m = len(X), len(Y)
    return (2 * torch.cdist(X, Y).mean() - torch.cdist(X, X).sum() / (n * (n - 1))
            - torch.cdist(Y, Y).sum() / (m * (m - 1))).item()

lam, n = 0.5, 2000
ref = echantillons(lam, n)
ang = torch.arange(4) * math.pi / 2 + lam * math.pi / 4
centres = (1 + lam) * torch.stack([torch.cos(ang), torch.sin(ang)], 1)
RAYLEIGH = math.sqrt(2 * math.log(2))                       # loi de Rayleigh : médiane = σ √(2 ln 2)
def resume(x):
    dmin, j = torch.cdist(x, centres).min(1)                # distance au centre exact le plus proche
    proche = dmin < 0.6
    cg = torch.stack([x[proche & (j == q)].mean(0) for q in range(4)])   # centres empiriques des modes
    dg = (x[proche] - cg[j[proche]]).norm(dim=1)
    return (dmin.median().item() / RAYLEIGH, dg.median().item() / RAYLEIGH,
            (cg - centres).norm(dim=1).mean().item(), (~proche).float().mean().item(),
            x.norm(dim=1).median().item())
print("            largeur   largeur      décalage   entre les   rayon    D_E")
print("            (exacts)  (empiriques) des modes  modes       médian")
print("données   : {:.3f}     {:.3f}        {:.3f}      {:.4f}      {:.3f}".format(*resume(ref)))
for w in [0.0, 1.0, 3.0]:
    x = echantillonner(lam, n, w)
    print("w = {:3.1f}   : {:.3f}     {:.3f}        {:.3f}      {:.4f}      {:.3f}   {:.4f}".format(
          w, *resume(x), distance_energie(x, ref)))
# sortie :
#             largeur   largeur      décalage   entre les   rayon    D_E
#             (exacts)  (empiriques) des modes  modes       médian
# données   : 0.150     0.150        0.012      0.0000      1.499
# w = 0.0   : 0.150     0.141        0.029      0.0620      1.476   0.0026
# w = 1.0   : 0.097     0.065        0.083      0.0205      1.499   0.0109
# w = 3.0   : 0.155     0.023        0.181      0.0025      1.529   0.0574
Sans guidage (w = 0), la largeur des modes est correcte mais 6 % des points restent entre les modes : ce modèle, qui partage sa capacité entre les tâches conditionnelle et non conditionnelle, est un peu moins bon que celui de la section 5.6. Le guidage nettoie l’espace entre les modes (6 % → 2 % → 0,25 %), mais il déforme la loi de deux façons. D’abord, mesurée autour de leurs propres centres, la largeur des modes chute de 0{,}14 à 0{,}065 pour w = 1, puis à 0{,}023 pour w = 3 : c’est la réduction de la dispersion prévue par l’exercice 12. Ensuite, les modes se déplacent, de 0{,}08 puis de 0{,}18 par rapport à leur position exacte (le rayon médian passe à 1{,}53 pour w = 3), ce qui rappelle l’exagération de la condition dans l’exercice 12. La largeur mesurée autour des centres exacts mélange les deux effets : à w = 3, sa valeur (0{,}155, proche de celle des données) ne reflète que le déplacement des modes, ce qui montre qu’un indicateur isolé peut tromper. La distance d’énergie, elle, est multipliée par 4 puis par 20. Pour reproduire une loi physique, il faut donc w = 0 et investir plutôt dans le modèle lui-même ; le guidage n’a d’intérêt que si l’on accepte de sacrifier la fidélité statistique.
★ Bruit en espace de fonctions. Sur [0, 1) périodique, on considère x_0 = \sum_{k \ne 0}\sqrt{\kappa_k}\,\xi_k\,e^{2i\pi ks} avec \kappa_k = |k|^{-\alpha} (et \xi_{-k} = \bar\xi_k pour un champ réel). (a) Pour quelles valeurs de \alpha a-t-on \mathbb{E}\|x_0\|_{L^2}^2 < \infty ? (b) Sur une grille de N points, combien vaut \mathbb{E}\|x_0\|^2 pour le bruit blanc ? Comparer à la sortie du bloc de la section 6.2. (c) Pour \alpha = 2, que vaut \mathbb{E}\|x_0\|^2 ?
Solution : (a) Par la proposition 6.3, \mathbb{E}\|x_0\|^2 = \sum_{k \ne 0}|k|^{-\alpha} = 2\sum_{k \ge 1}k^{-\alpha}, finie si et seulement si \alpha > 1 (série de Riemann). (b) Sur N points, seuls les modes 1 \le |k| < N/2 sont représentés, soit environ N modes de variance 1 : \mathbb{E}\|x_0\|^2 \approx N et la norme croît comme \sqrt N. Le bloc donne 5{,}4 ; 10{,}7 ; 23{,}0 ; 44{,}4 pour N = 32, 128, 512, 2048, à comparer à \sqrt N = 5{,}7 ; 11{,}3 ; 22{,}6 ; 45{,}3. (c) \mathbb{E}\|x_0\|^2 = 2\zeta(2) = \pi^2/3 \approx 3{,}29, soit une norme typique de l’ordre de 1{,}8 ; la réalisation du bloc (2{,}19) est compatible, les premiers modes, peu nombreux, dominant la fluctuation. Plus généralement, comme la norme de Sobolev H^r pondère le mode k par un facteur de l’ordre de (2\pi k)^{2r}, \mathbb{E}\|x_0\|_{H^r}^2 est fini si et seulement si \sum_{k \ge 1} k^{2r - \alpha} l’est, c’est-à-dire si \alpha > 2r + 1 : la décroissance du spectre fixe la régularité des échantillons.
★★★ Distance d’énergie en dimension 1. Soient P et Q deux lois sur \mathbb{R} à premier moment fini, de fonctions de répartition F et G. (a) Montrer que \mathcal{E}(P, Q) = 2\int_{\mathbb{R}}(F(u) - G(u))^2\,\mathrm{d}u. (b) En déduire que \mathcal{E} \ge 0 avec égalité si et seulement si P = Q. (c) Calculer \mathcal{E}\big(\mathcal{N}(0, 1), \mathcal{N}(\delta, 1)\big) pour \delta petit.
Solution : (a) Pour deux réels, |x - y| = \int_{\mathbb{R}}\big(\mathbf{1}_{x \le u < y} + \mathbf{1}_{y \le u < x}\big)\,\mathrm{d}u. Pour X \sim P et Y \sim Q indépendants, le théorème de Fubini donne \mathbb{E}|X - Y| = \int\big[F(u)(1 - G(u)) + G(u)(1 - F(u))\big]\mathrm{d}u, et de même \mathbb{E}|X - X'| = \int 2F(1 - F), \mathbb{E}|Y - Y'| = \int 2G(1 - G). On combine :
2\big[F(1 - G) + G(1 - F)\big] - 2F(1 - F) - 2G(1 - G) = 2F^2 - 4FG + 2G^2 = 2(F - G)^2.
- L’intégrale d’un carré est positive ; elle est nulle si et seulement si F = G presque partout, donc partout par continuité à droite, c’est-à-dire P = Q. (c) Ici F(u) - G(u) = \Phi(u) - \Phi(u - \delta) \approx \delta\,\varphi(u), et \int\varphi^2 = 1/(2\sqrt\pi), d’où \mathcal{E} \approx \delta^2/\sqrt\pi. Pour \delta = 0{,}1, l’intégrale exacte vaut 0{,}005640 et l’approximation 0{,}005642. La distance d’énergie est quadratique en un petit décalage : c’est pourquoi les valeurs mesurées au chapitre 7 sont si petites, et pourquoi il faut les comparer au plancher de bruit plutôt qu’à zéro.
Lien avec le stage
L’offre de stage demande de développer des modèles génératifs conditionnels, par diffusion ou flow matching, de champs physiques paramétrés, d’y imposer des contraintes issues des équations et des conditions aux limites « par la conception du modèle, les pertes d’entraînement ou les procédures d’échantillonnage », et de les valider sur des EDP simples puis sur des champs MHD avec des métriques de spectres, d’hélicité, de divergence et de topologie. Ce module fournit les outils de la première moitié de ce programme ; le module p8 traite la seconde. Voici où chaque chapitre intervient dans les expériences réellement menées dans ce dépôt (les résultats chiffrés sont dans le rapport, pas ici).
- Expérience E1 (rapport, section E1). Un modèle de flow matching conditionnel (chapitres 4 et 5) apprend la loi invariante du modèle à trois modes de renversements de Gissinger (2012) en fonction du paramètre de forçage \Gamma, entraîné sur une grille de valeurs et testé entre elles (remarque 5.3). La symétrie (Q, D, V) \to (-Q, -D, V), analogue du renversement \mathbf{B} \to -\mathbf{B}, y est imposée par augmentation des données ou par un champ de vitesse équivariant ; des identités de stationnarité sont imposées en loi ; la fréquence des renversements est estimée à partir de la seule loi générée par la formule de Rice. L’évaluation utilise la distance d’énergie et la distance de Wasserstein tranchée (chapitre 7).
- Expérience E2 (rapport, section E2). Des champs MHD 2D forcés (\mathbf{u}, \mathbf{B}) sont générés conditionnellement à la diffusivité magnétique \eta, et cinq mécanismes de contrainte de divergence sont comparés à réseau et budget égaux : génération libre, pénalité sur l’estimée débruitée \hat{\mathbf{x}}_1 = \mathbf{x}_t + (1 - t)v_\theta (proposition 5.6, sans écart de Jensen car la divergence est linéaire), projection finale, flot projeté (bruit et pas projetés) et génération de potentiels (\psi, a) (proposition 6.2). Le bilan d’énergie, quadratique, est traité en loi plutôt que sur l’estimée débruitée (section 5.5).
- Expérience E3 (rapport, section E3). Le taux de croissance de la dynamo cinématique ABC en fonction de Rm fournit un exemple de dépendance paramétrique avec seuil : un modèle conditionnel en Rm doit traverser ce seuil, ce qui est exactement la situation où l’interpolation en \boldsymbol\lambda n’est garantie par aucun théorème.
- La formulation du problème et la taxonomie des contraintes (où agit la contrainte : architecture, perte, échantillonnage ; dure ou douce) sont développées dans le rapport (formulation, taxonomie). Le sujet de thèse en tire une partie théorique et un plan expérimental.
Trois enseignements de ce module orientent ces choix. D’abord, flow matching et diffusion sont deux paramétrisations du même objet (proposition 4.13) : le choix entre eux relève du chemin, du solveur et de la commodité (le flow matching donne directement l’estimée débruitée et des chemins plus droits), pas d’une différence de principe. Ensuite, les contraintes linéaires (divergence) et non linéaires (énergie, résidus) ne se traitent pas de la même façon, à cause de l’écart de Jensen. Enfin, l’évaluation doit comparer chaque mécanisme au plancher de bruit, dans et hors de la plage de paramètres, et avec des métriques physiques ; la comparaison publiée la plus proche, celle de Genuist et al. (2026, préprint) sur la seule divergence en hydrodynamique 2D, montre qu’aucune stratégie ne domine partout : les contraintes strictes y sont meilleures en distribution, mais une pénalité douce l’emporte parfois hors distribution.
Pour aller plus loin
- Lipman et al. (2024), Flow Matching Guide and Code. Un guide complet, écrit par les auteurs du flow matching, avec les démonstrations générales (chemins conditionnels quelconques, variétés, espaces discrets) et une bibliothèque de code. C’est la suite naturelle du chapitre 4.
- Albergo, Boffi & Vanden-Eijnden (2025), Stochastic Interpolants: A Unifying Framework for Flows and Diffusions. La version la plus générale du cadre de la section 4.5 : interpolants avec bruit, choix du coefficient de diffusion à l’échantillonnage, lien avec le pont de Schrödinger. À lire pour comprendre pourquoi ODE et EDS sont deux faces d’un même modèle.
- Karras et al. (2022), Elucidating the Design Space of Diffusion-Based Generative Models. L’article qui démonte chaque choix de conception de la diffusion (planning, préconditionnement, solveur) et le justifie ; ses annexes contiennent les démonstrations de la section 3.4 et une analyse de l’erreur d’intégration.
- Song et al. (2021), Score-Based Generative Modeling through Stochastic Differential Equations. Le texte fondateur de la vue continue (chapitre 3), avec l’échantillonnage prédicteur-correcteur et le calcul exact de la vraisemblance par l’ODE de flot.
- Papamakarios et al. (2021), Normalizing Flows for Probabilistic Modeling and Inference. Une revue pédagogique des flots normalisants (chapitre 1), utile pour comprendre ce que le flow matching a rendu inutile et ce qu’il en a gardé.
- Kerrigan, Migliorini & Smyth (2024), Functional Flow Matching, et Lim et al. (2025), Score-Based Diffusion Models in Function Space. Les deux références pour la génération en dimension infinie (chapitre 6), indispensables si le stage passe des champs sur grille aux opérateurs.
Sources
- M. S. Albergo, E. Vanden-Eijnden (2023). « Building Normalizing Flows with Stochastic Interpolants ». International Conference on Learning Representations (ICLR 2023). arXiv:2209.15571. https://arxiv.org/abs/2209.15571
- M. S. Albergo, N. M. Boffi, E. Vanden-Eijnden (2025). « Stochastic Interpolants: A Unifying Framework for Flows and Diffusions ». Journal of Machine Learning Research 26(209), 1–80. arXiv:2303.08797. https://jmlr.org/papers/v26/23-1605.html
- B. D. O. Anderson (1982). « Reverse-time diffusion equation models ». Stochastic Processes and their Applications 12(3), 313–326. DOI 10.1016/0304-4149(82)90051-5. https://doi.org/10.1016/0304-4149(82)90051-5
- A. Bansal, H.-M. Chu, A. Schwarzschild, S. Sengupta, M. Goldblum, J. Geiping, T. Goldstein (2024). « Universal Guidance for Diffusion Models ». ICLR 2024. arXiv:2302.07121. https://arxiv.org/abs/2302.07121
- J.-H. Bastek, W. Sun, D. M. Kochmann (2025). « Physics-Informed Diffusion Models ». ICLR 2025. arXiv:2403.14404. https://arxiv.org/abs/2403.14404
- L. Biferale, M. Buzzicotti (2026). « Generative AI in Turbulence: Foundations, Applications, Validations and Benchmarks ». Préprint, arXiv:2610.35123. https://arxiv.org/abs/2610.35123
- N. Bonneel, J. Rabin, G. Peyré, H. Pfister (2015). « Sliced and Radon Wasserstein Barycenters of Measures ». Journal of Mathematical Imaging and Vision 51(1), 22–45. DOI 10.1007/s10851-014-0506-3. https://doi.org/10.1007/s10851-014-0506-3
- R. T. Q. Chen, Y. Rubanova, J. Bettencourt, D. Duvenaud (2018). « Neural Ordinary Differential Equations ». Advances in Neural Information Processing Systems 31 (NeurIPS 2018). arXiv:1806.07366. https://arxiv.org/abs/1806.07366
- H. Chung, J. Kim, M. T. McCann, M. L. Klasky, J. C. Ye (2023). « Diffusion Posterior Sampling for General Noisy Inverse Problems ». ICLR 2023. arXiv:2209.14687. https://arxiv.org/abs/2209.14687
- D. Cohen-Steiner, H. Edelsbrunner, J. Harer (2007). « Stability of Persistence Diagrams ». Discrete & Computational Geometry 37(1), 103–120. DOI 10.1007/s00454-006-1276-5. https://doi.org/10.1007/s00454-006-1276-5
- P. Dhariwal, A. Nichol (2021). « Diffusion Models Beat GANs on Image Synthesis ». Advances in Neural Information Processing Systems 34 (NeurIPS 2021). arXiv:2105.05233. https://arxiv.org/abs/2105.05233
- L. Dinh, J. Sohl-Dickstein, S. Bengio (2017). « Density estimation using Real NVP ». ICLR 2017. arXiv:1605.08803. https://arxiv.org/abs/1605.08803
- B. Efron (2011). « Tweedie’s Formula and Selection Bias ». Journal of the American Statistical Association 106(496), 1602–1614. DOI 10.1198/jasa.2011.tm11181. https://doi.org/10.1198/jasa.2011.tm11181
- W. Genuist, É. Savin, F. Gatti, D. Clouteau (2026). « Divergence-Free Diffusion Models for Incompressible Fluid Flows ». Préprint, arXiv:2601.19368. https://arxiv.org/abs/2601.19368
- C. Gissinger (2012). « A new deterministic model for chaotic reversals ». The European Physical Journal B 85(4), 137. DOI 10.1140/epjb/e2012-20799-5. arXiv:1109.6569. https://doi.org/10.1140/epjb/e2012-20799-5
- M. Heusel, H. Ramsauer, T. Unterthiner, B. Nessler, S. Hochreiter (2017). « GANs Trained by a Two Time-Scale Update Rule Converge to a Local Nash Equilibrium ». Advances in Neural Information Processing Systems 30 (NIPS 2017). arXiv:1706.08500. https://arxiv.org/abs/1706.08500
- J. Ho, A. Jain, P. Abbeel (2020). « Denoising Diffusion Probabilistic Models ». Advances in Neural Information Processing Systems 33 (NeurIPS 2020). arXiv:2006.11239. https://proceedings.neurips.cc/paper/2020/hash/4c5bcfec8584af0d967f1ab10179ca4b-Abstract.html
- J. Ho, T. Salimans (2022). « Classifier-Free Diffusion Guidance ». arXiv:2207.12598 (version courte au NeurIPS 2021 Workshop on Deep Generative Models and Downstream Applications). https://arxiv.org/abs/2207.12598
- A. Hyvärinen (2005). « Estimation of Non-Normalized Statistical Models by Score Matching ». Journal of Machine Learning Research 6, 695–709. https://jmlr.org/papers/v6/hyvarinen05a.html
- T. Karras, M. Aittala, T. Aila, S. Laine (2022). « Elucidating the Design Space of Diffusion-Based Generative Models ». Advances in Neural Information Processing Systems 35 (NeurIPS 2022). arXiv:2206.00364. https://arxiv.org/abs/2206.00364
- G. Kerrigan, G. Migliorini, P. Smyth (2024). « Functional Flow Matching ». Proceedings of the 27th International Conference on Artificial Intelligence and Statistics (AISTATS 2024), PMLR 238, 3934–3942. arXiv:2305.17209. https://proceedings.mlr.press/v238/kerrigan24a.html
- D. P. Kingma, T. Salimans, B. Poole, J. Ho (2021). « Variational Diffusion Models ». Advances in Neural Information Processing Systems 34 (NeurIPS 2021). arXiv:2107.00630. https://arxiv.org/abs/2107.00630
- G. Kohl, L.-W. Chen, N. Thuerey (2026). « Benchmarking autoregressive conditional diffusion models for turbulent flow simulation ». Neural Networks 199, 108641. DOI 10.1016/j.neunet.2026.108641. arXiv:2309.01745. https://doi.org/10.1016/j.neunet.2026.108641
- M. Lienen, D. Lüdke, J. Hansen-Palmus, S. Günnemann (2024). « From Zero to Turbulence: Generative Modeling for 3D Flow Simulation ». ICLR 2024. arXiv:2306.01776. https://arxiv.org/abs/2306.01776
- J. H. Lim, N. B. Kovachki, R. Baptista, C. Beckham, K. Azizzadenesheli, J. Kossaifi, V. Voleti, J. Song, K. Kreis, J. Kautz, C. Pal, A. Vahdat, A. Anandkumar (2025). « Score-Based Diffusion Models in Function Space ». Journal of Machine Learning Research 26(158), 1–62. https://jmlr.org/papers/v26/23-1472.html
- Y. Lipman, R. T. Q. Chen, H. Ben-Hamu, M. Nickel, M. Le (2023). « Flow Matching for Generative Modeling ». ICLR 2023. arXiv:2210.02747. https://arxiv.org/abs/2210.02747
- Y. Lipman, M. Havasi, P. Holderrieth, N. Shaul, M. Le, B. Karrer, R. T. Q. Chen, D. Lopez-Paz, H. Ben-Hamu, I. Gat (2024). « Flow Matching Guide and Code ». arXiv:2412.06264. https://arxiv.org/abs/2412.06264
- X. Liu, C. Gong, Q. Liu (2023). « Flow Straight and Fast: Learning to Generate and Transfer Data with Rectified Flow ». ICLR 2023. arXiv:2209.03003. https://arxiv.org/abs/2209.03003
- G. Papamakarios, E. Nalisnick, D. J. Rezende, S. Mohamed, B. Lakshminarayanan (2021). « Normalizing Flows for Probabilistic Modeling and Inference ». Journal of Machine Learning Research 22(57), 1–64. arXiv:1912.02762. https://jmlr.org/papers/v22/19-1028.html
- J. Rabin, G. Peyré, J. Delon, M. Bernot (2012). « Wasserstein Barycenter and Its Application to Texture Mixing ». Scale Space and Variational Methods in Computer Vision (SSVM 2011), Lecture Notes in Computer Science, 435–446. DOI 10.1007/978-3-642-24785-9_37. https://doi.org/10.1007/978-3-642-24785-9_37
- D. J. Rezende, S. Mohamed (2015). « Variational Inference with Normalizing Flows ». Proceedings of the 32nd International Conference on Machine Learning (ICML 2015), PMLR 37, 1530–1538. arXiv:1505.05770. https://proceedings.mlr.press/v37/rezende15.html
- R. Rombach, A. Blattmann, D. Lorenz, P. Esser, B. Ommer (2022). « High-Resolution Image Synthesis with Latent Diffusion Models ». Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR 2022), 10684–10695. arXiv:2112.10752. https://arxiv.org/abs/2112.10752
- D. Sejdinovic, B. Sriperumbudur, A. Gretton, K. Fukumizu (2013). « Equivalence of distance-based and RKHS-based statistics in hypothesis testing ». The Annals of Statistics 41(5), 2263–2291. DOI 10.1214/13-AOS1140. https://doi.org/10.1214/13-AOS1140
- J. Sohl-Dickstein, E. A. Weiss, N. Maheswaranathan, S. Ganguli (2015). « Deep Unsupervised Learning using Nonequilibrium Thermodynamics ». Proceedings of the 32nd International Conference on Machine Learning (ICML 2015), PMLR 37, 2256–2265. arXiv:1503.03585. https://proceedings.mlr.press/v37/sohl-dickstein15.html
- J. Song, C. Meng, S. Ermon (2021). « Denoising Diffusion Implicit Models ». ICLR 2021. arXiv:2010.02502. https://arxiv.org/abs/2010.02502
- Y. Song, S. Ermon (2019). « Generative Modeling by Estimating Gradients of the Data Distribution ». Advances in Neural Information Processing Systems 32 (NeurIPS 2019). arXiv:1907.05600. https://arxiv.org/abs/1907.05600
- Y. Song, J. Sohl-Dickstein, D. P. Kingma, A. Kumar, S. Ermon, B. Poole (2021). « Score-Based Generative Modeling through Stochastic Differential Equations ». ICLR 2021. arXiv:2011.13456. https://arxiv.org/abs/2011.13456
- G. J. Székely, M. L. Rizzo (2013). « Energy statistics: A class of statistics based on distances ». Journal of Statistical Planning and Inference 143(8), 1249–1272. DOI 10.1016/j.jspi.2013.03.018. https://doi.org/10.1016/j.jspi.2013.03.018
- L. Theis, A. van den Oord, M. Bethge (2016). « A note on the evaluation of generative models ». ICLR 2016. arXiv:1511.01844. https://arxiv.org/abs/1511.01844
- A. Tong, K. Fatras, N. Malkin, G. Huguet, Y. Zhang, J. Rector-Brooks, G. Wolf, Y. Bengio (2024). « Improving and generalizing flow-based generative models with minibatch optimal transport ». Transactions on Machine Learning Research (TMLR). arXiv:2302.00482. https://arxiv.org/abs/2302.00482
- P. Vincent (2011). « A Connection Between Score Matching and Denoising Autoencoders ». Neural Computation 23(7), 1661–1674. DOI 10.1162/NECO_a_00142. https://doi.org/10.1162/NECO_a_00142
- S. Wang, Z. Dou, S. Shan, T.-R. Liu, L. Lu (2026). « FunDiff: diffusion models over function spaces for physics-informed generative modeling ». Nature Communications 17, 5749. DOI 10.1038/s41467-026-72292-0. arXiv:2506.07902. https://doi.org/10.1038/s41467-026-72292-0